Enregistre les onglets en quelques secondes, les stocke pendant des décennies
Collectez des signets pour les lire plus tard ou conservez des preuves pour des affaires juridiques avec des captures vérifiables de notre Plugin de signature TLSNotary.
Archivage Web auto-hébergé open source
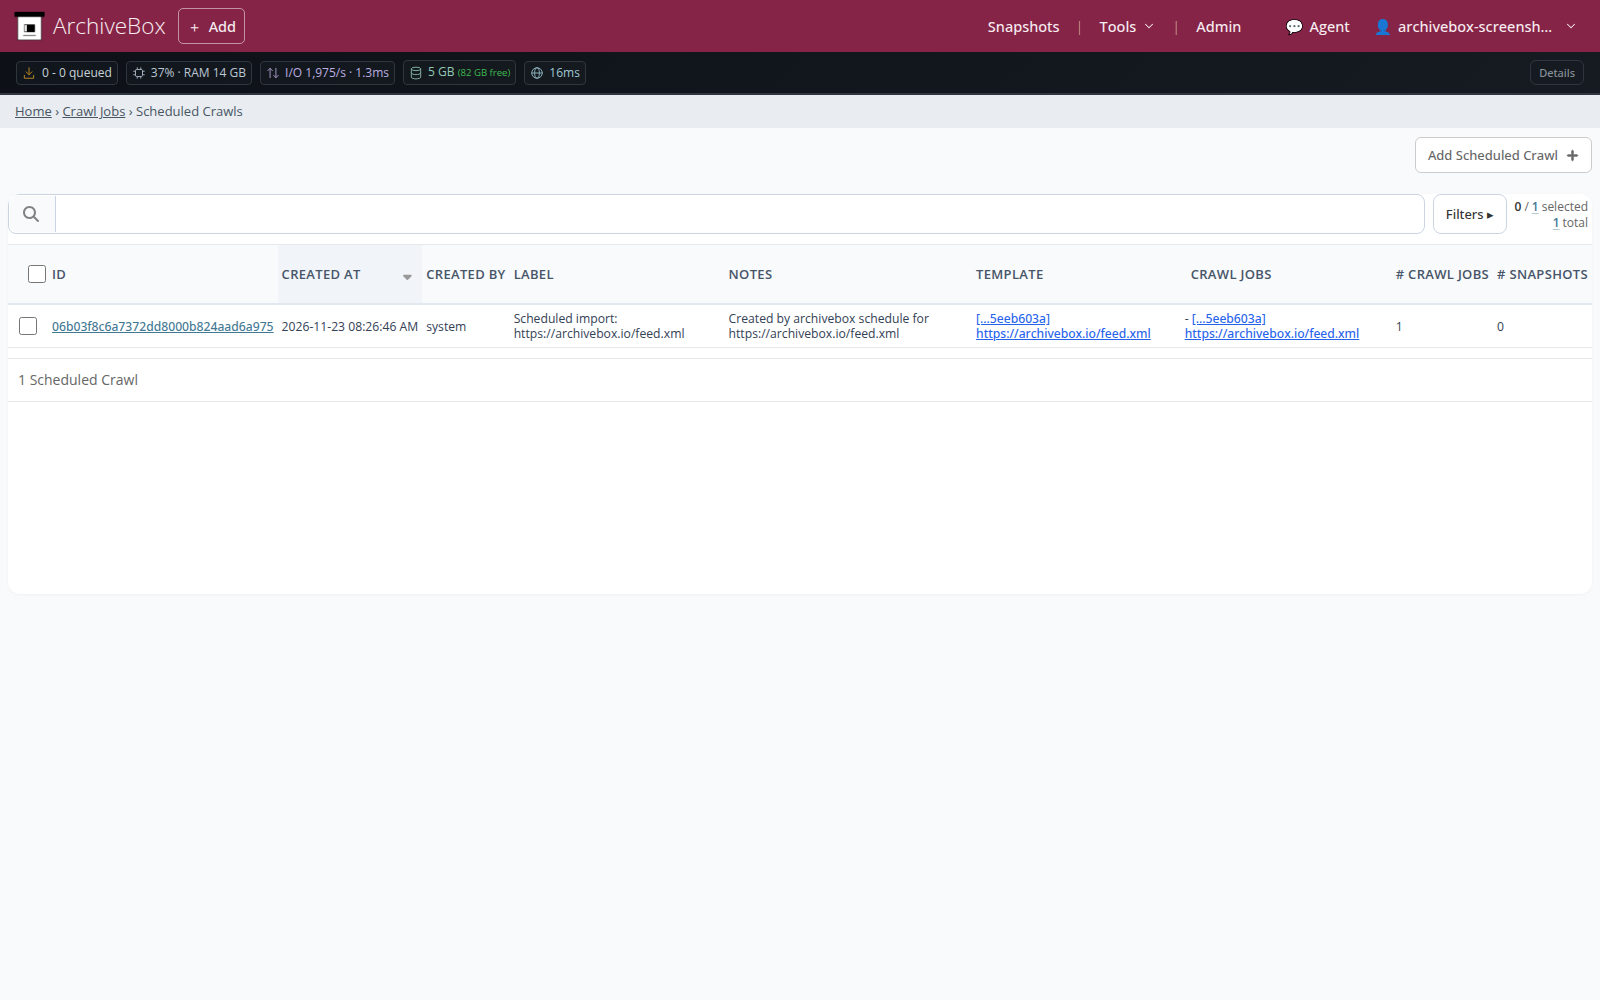
ArchiveBox enregistre les sites Web, les signets, les flux RSS, les publications sociales, les médias, le code source et le matériel de recherche dans des fichiers durables tels que HTML, PDF, PNG, TXT, JSON, WARC, MP4 et SQLite.
Voir les captures d'écran ↗ · Voir la démo ↗


# Docker Compose est la configuration recommandée
$ mkdir -p ~/archivebox/data && cd ~/archivebox
$ curl -fsSL 'https://docker-compose.archivebox.io' > docker-compose.yml
$ docker compose -d --wait
-> initialisé ./data/index.sqlite3
ok, j'écoute sur http://127.0.0.1:5797
$
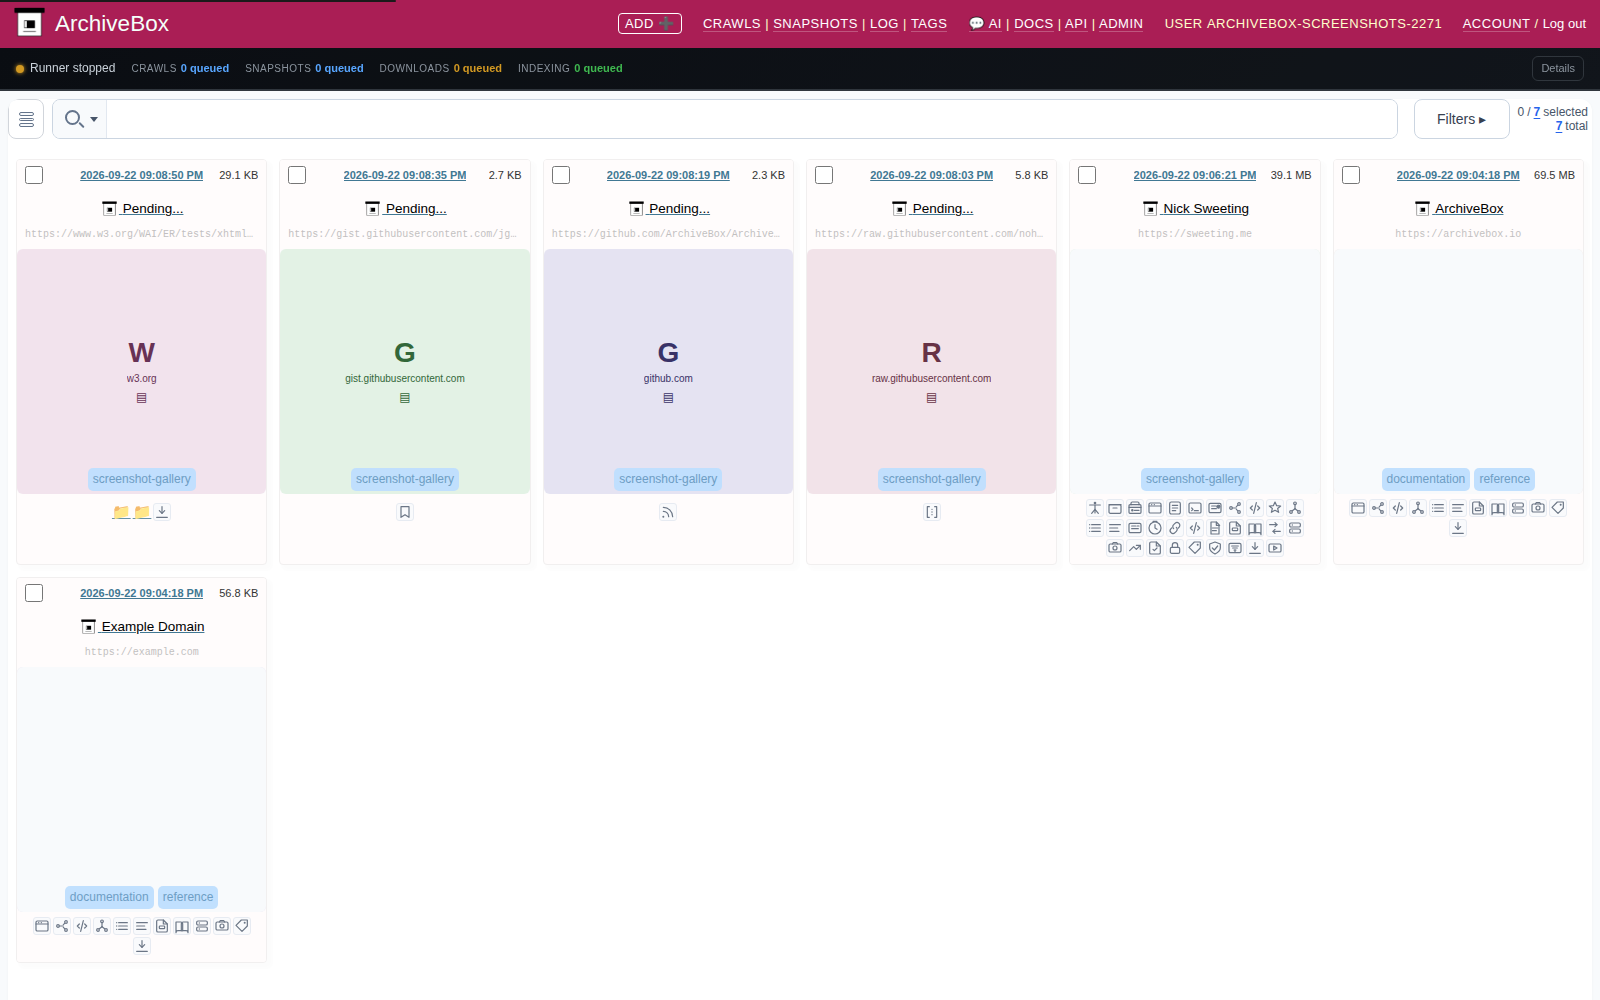
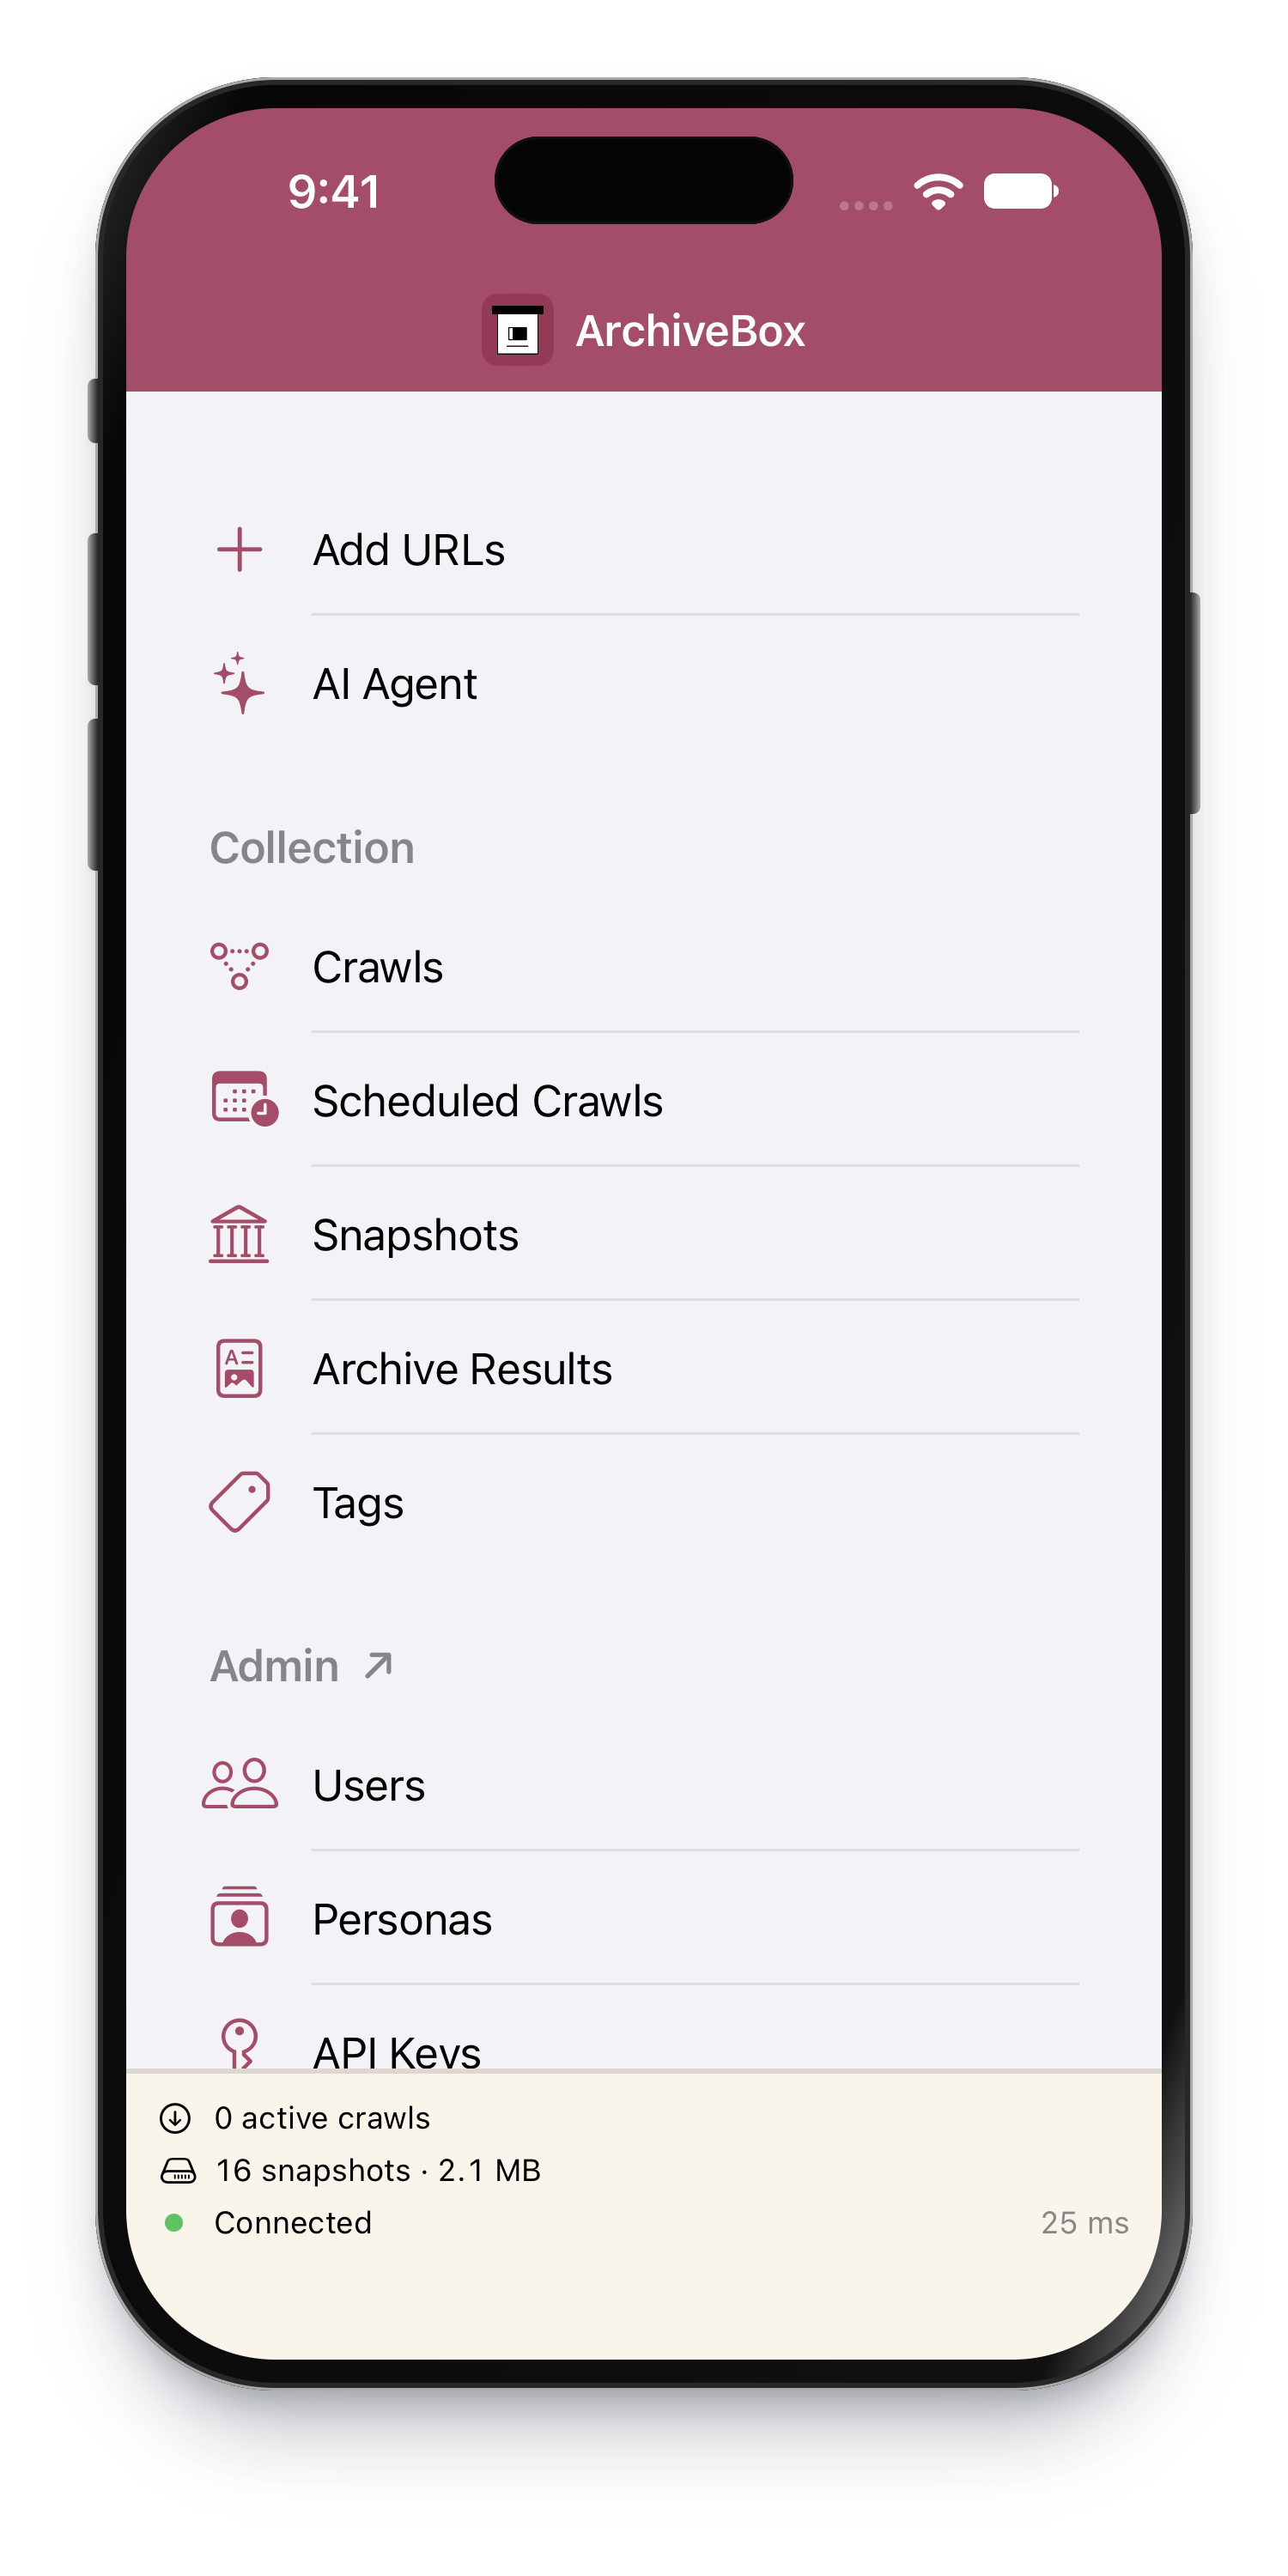
Parcourez et enregistrez depuis n’importe quel appareil.
Gratuit, auto-hébergé, 0 analyse.

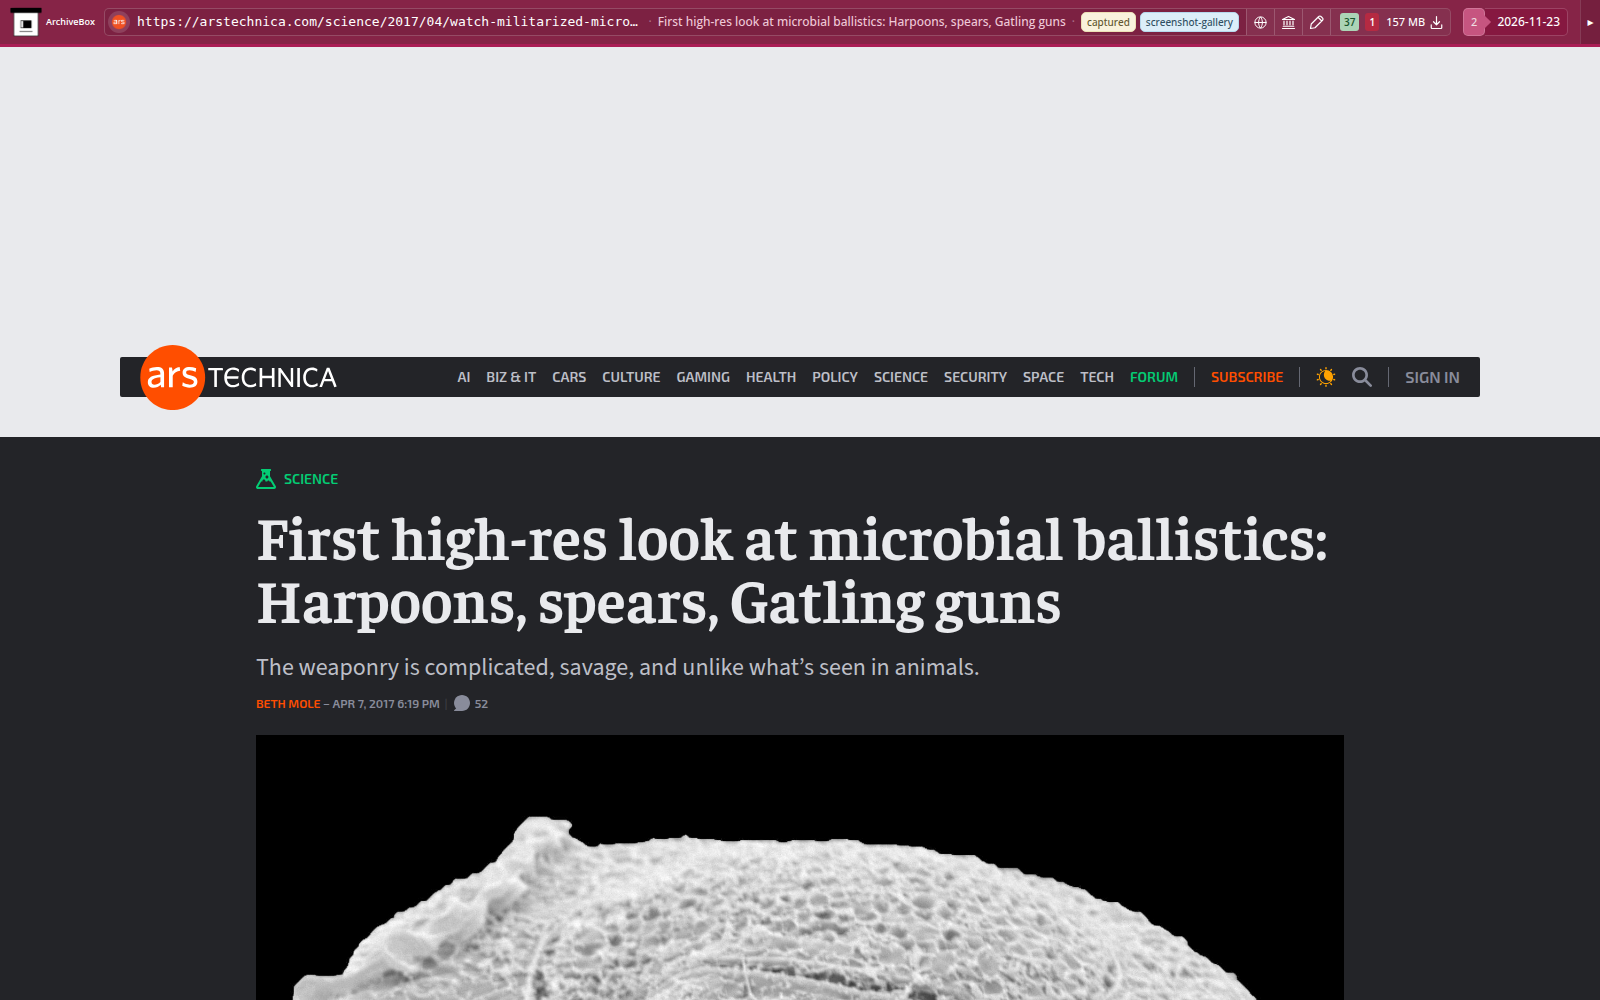

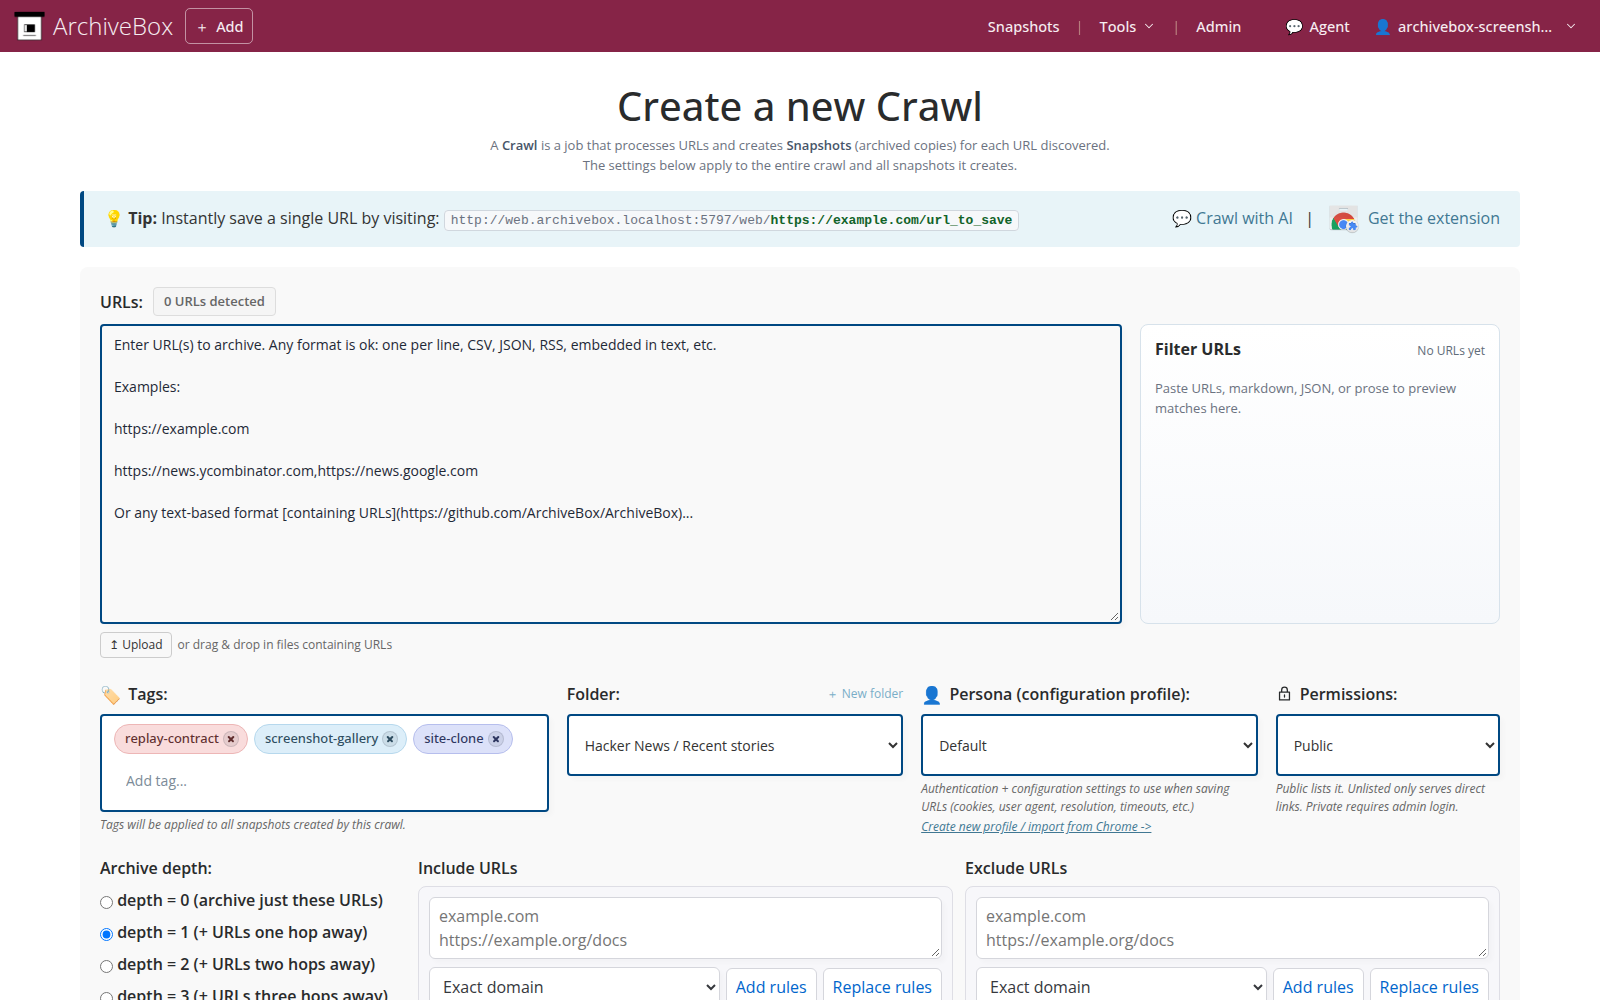

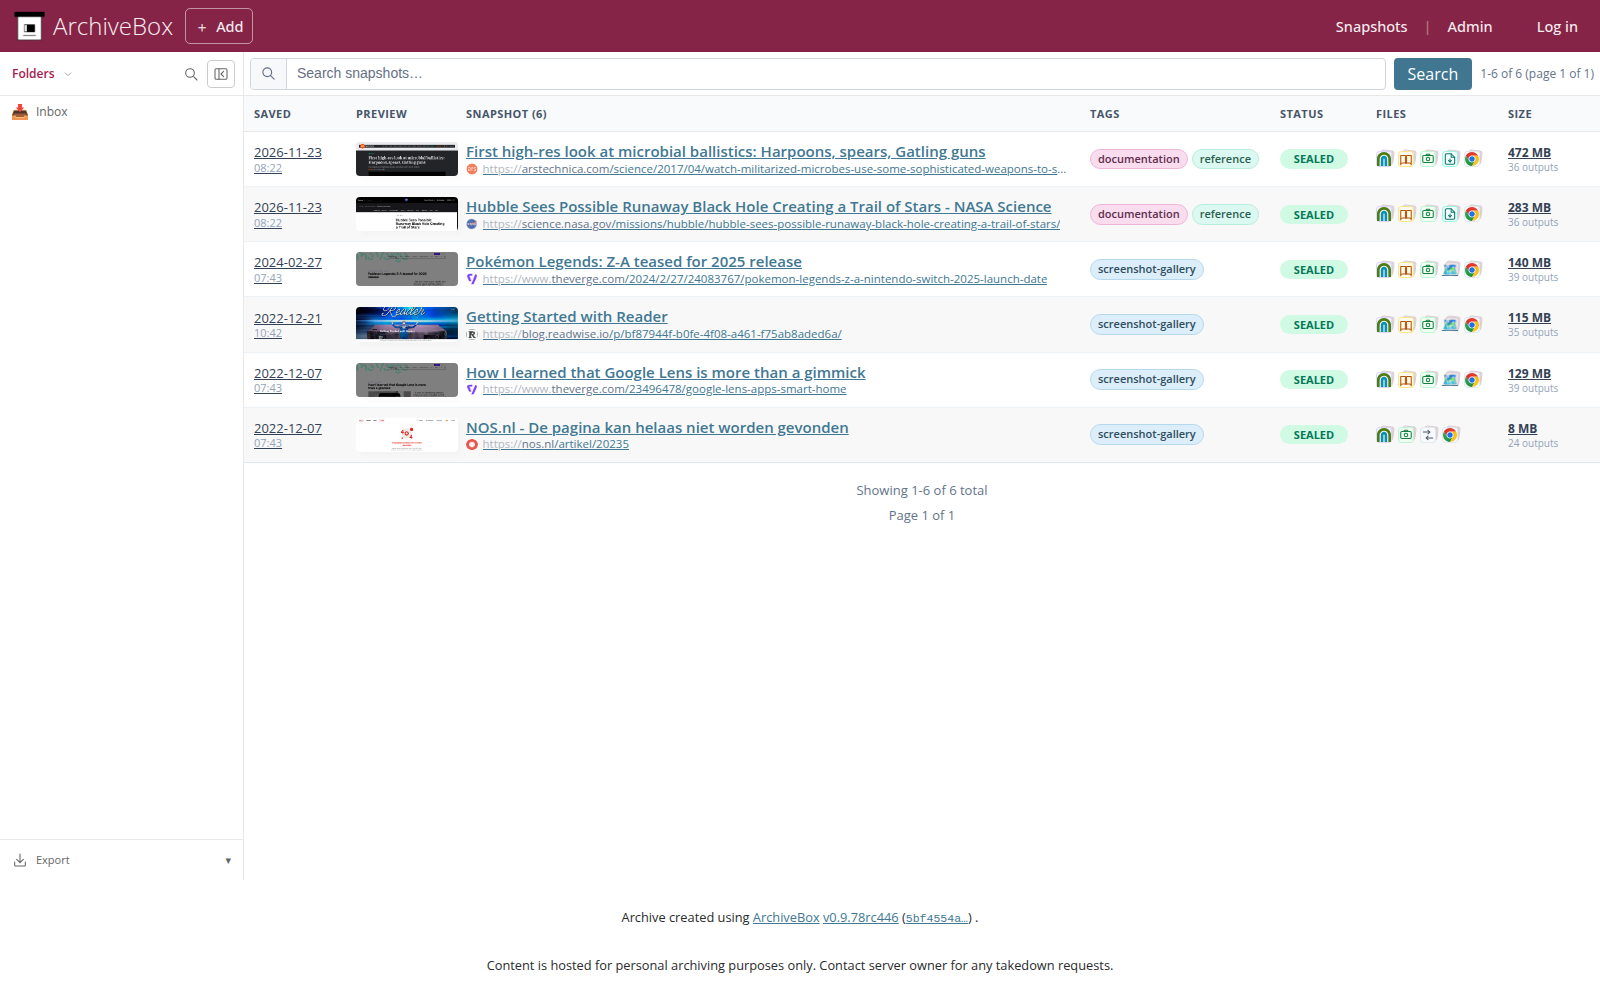
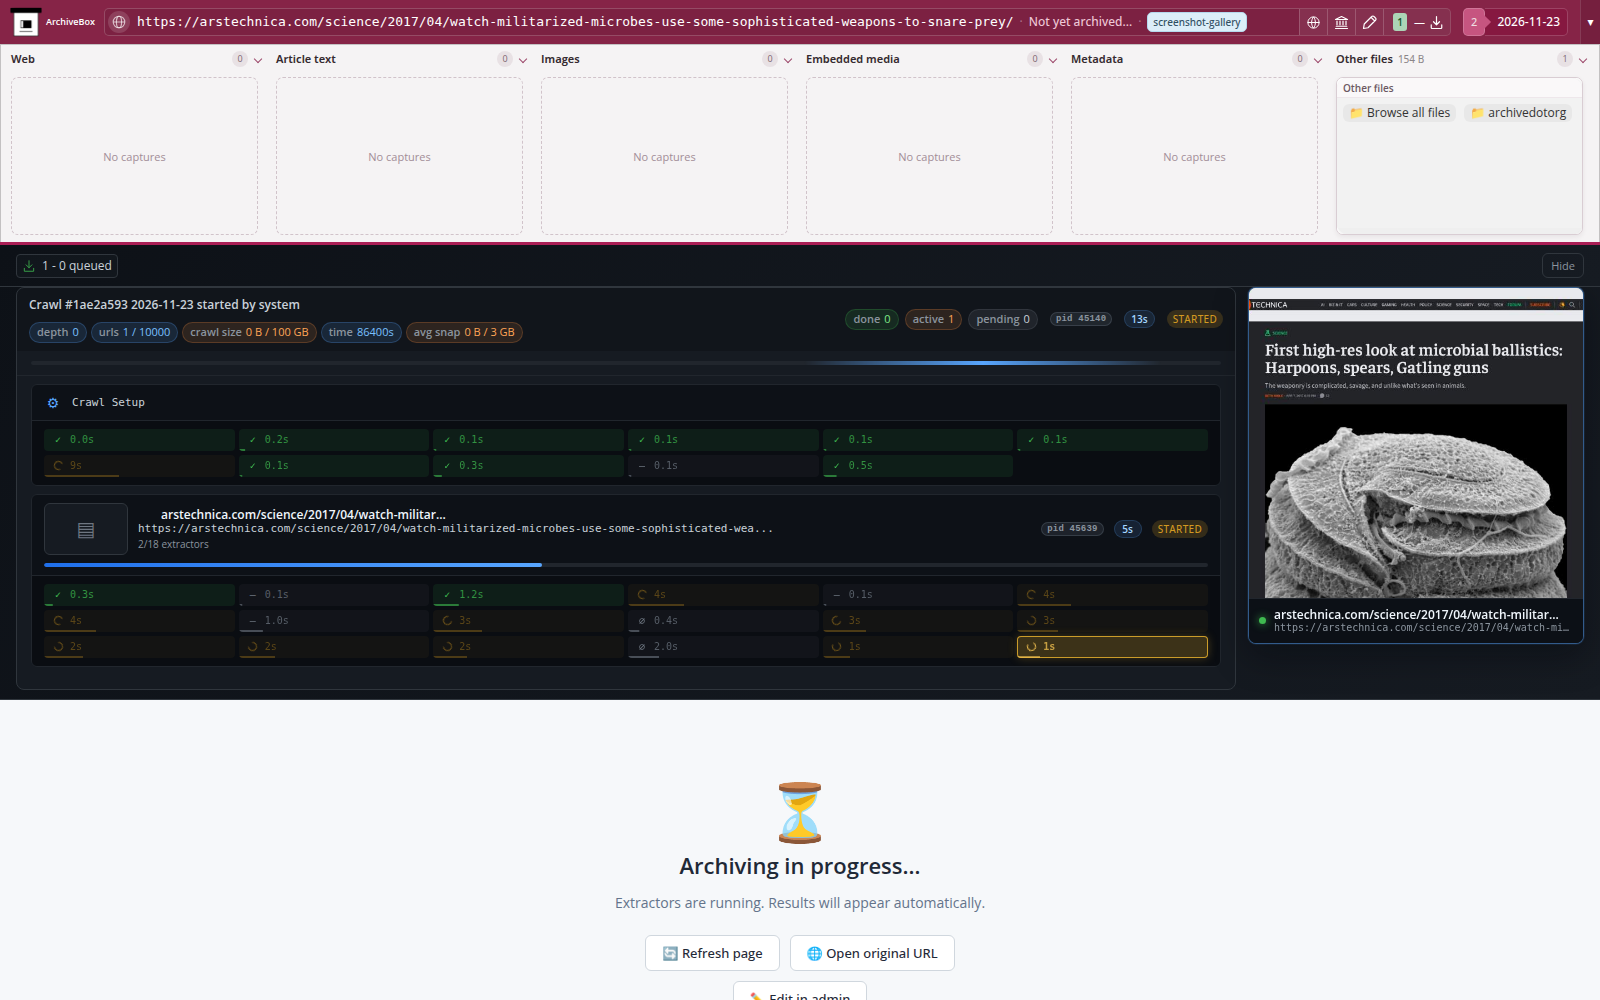
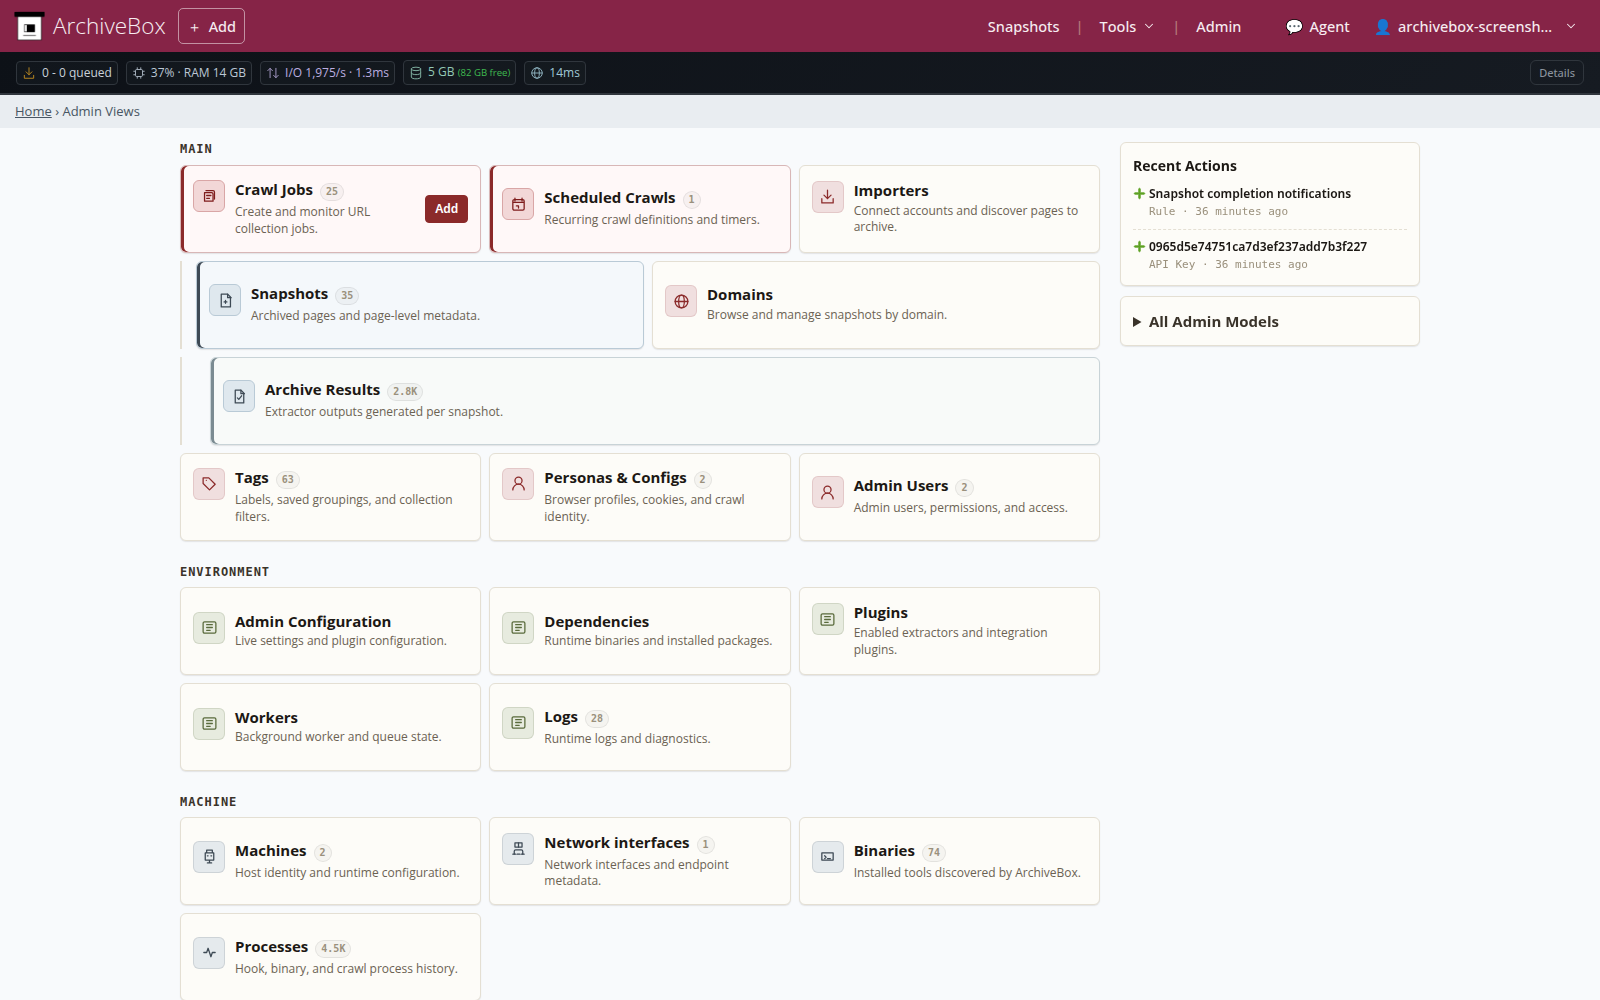










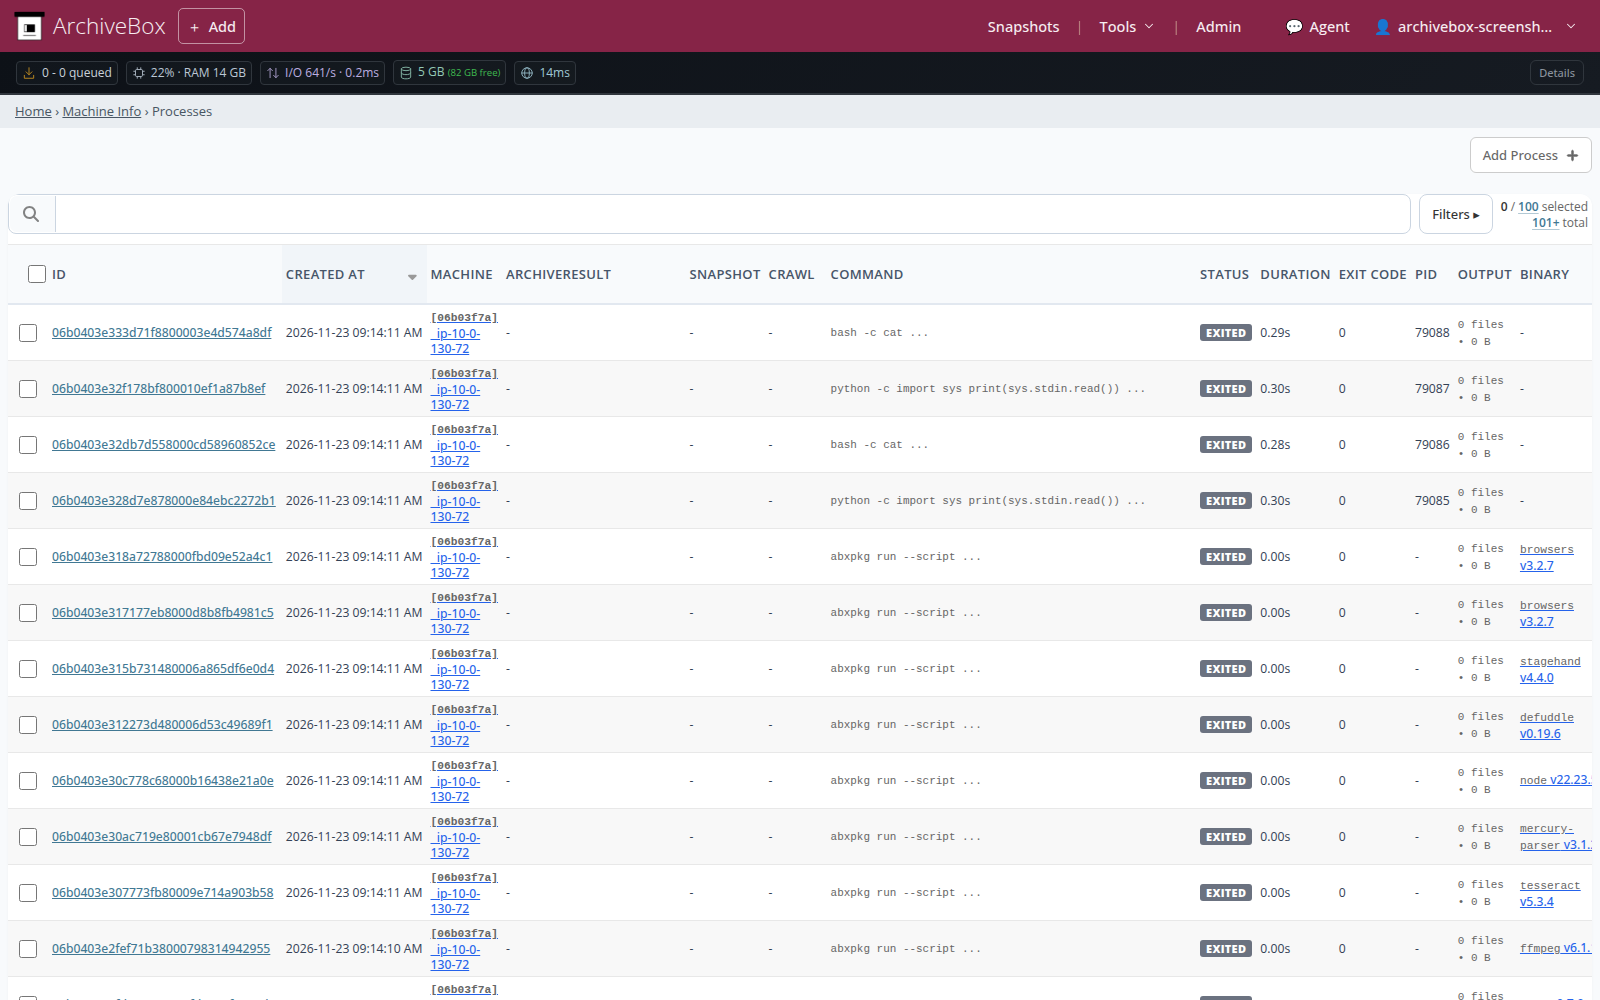



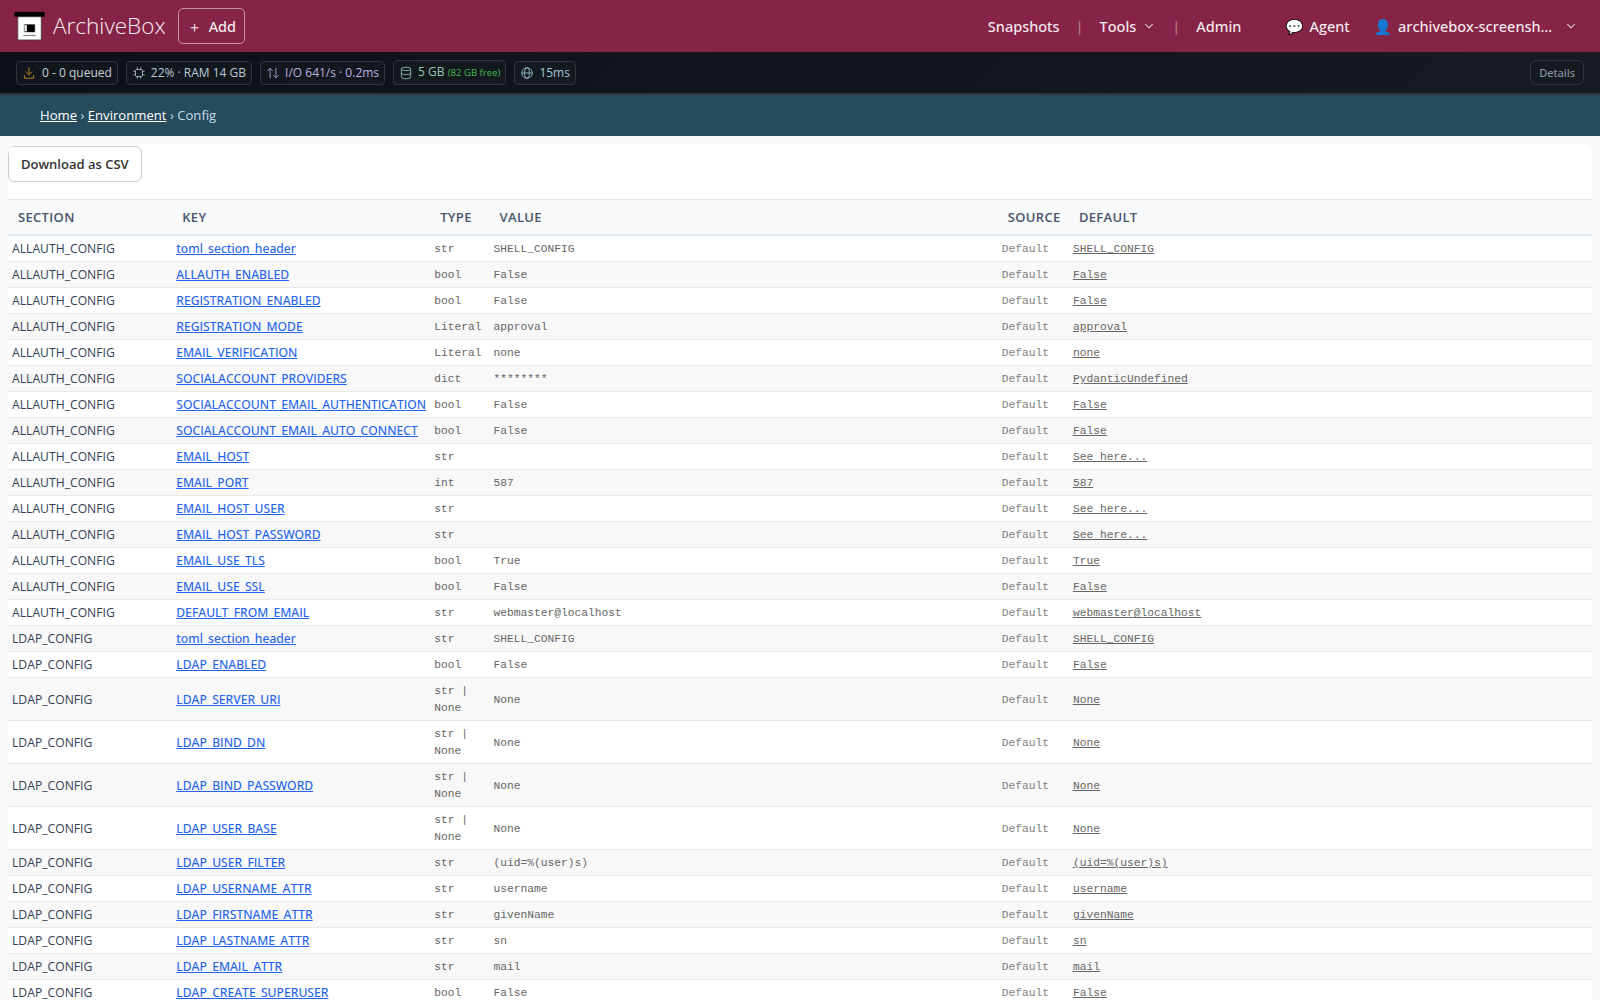

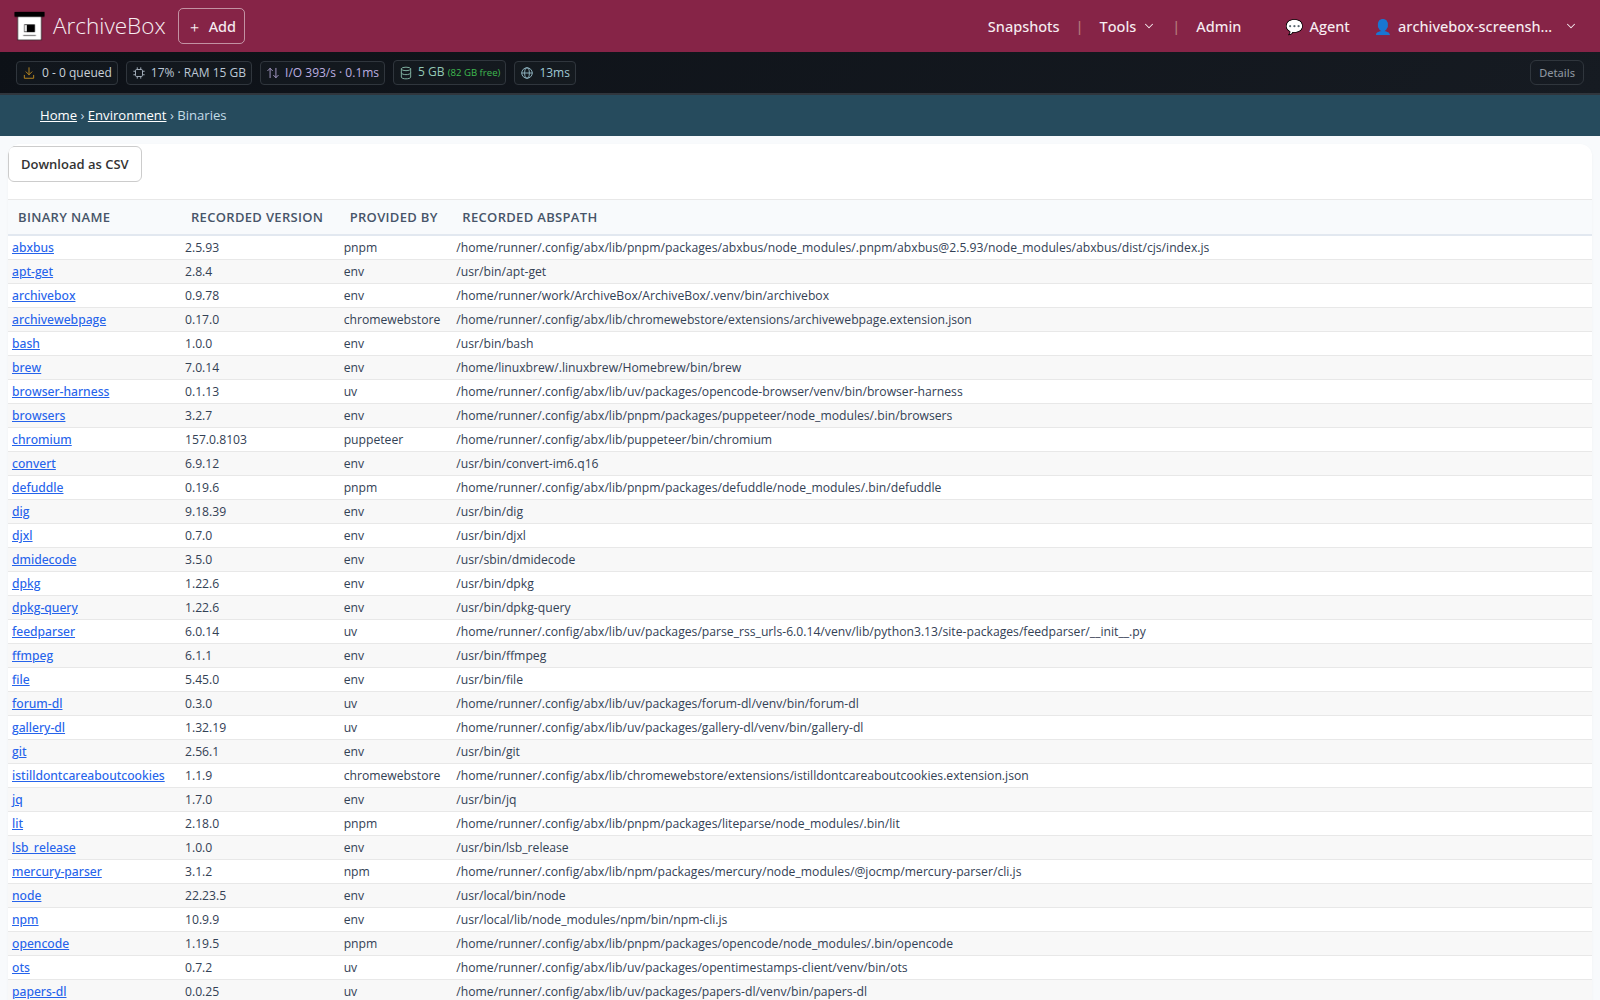

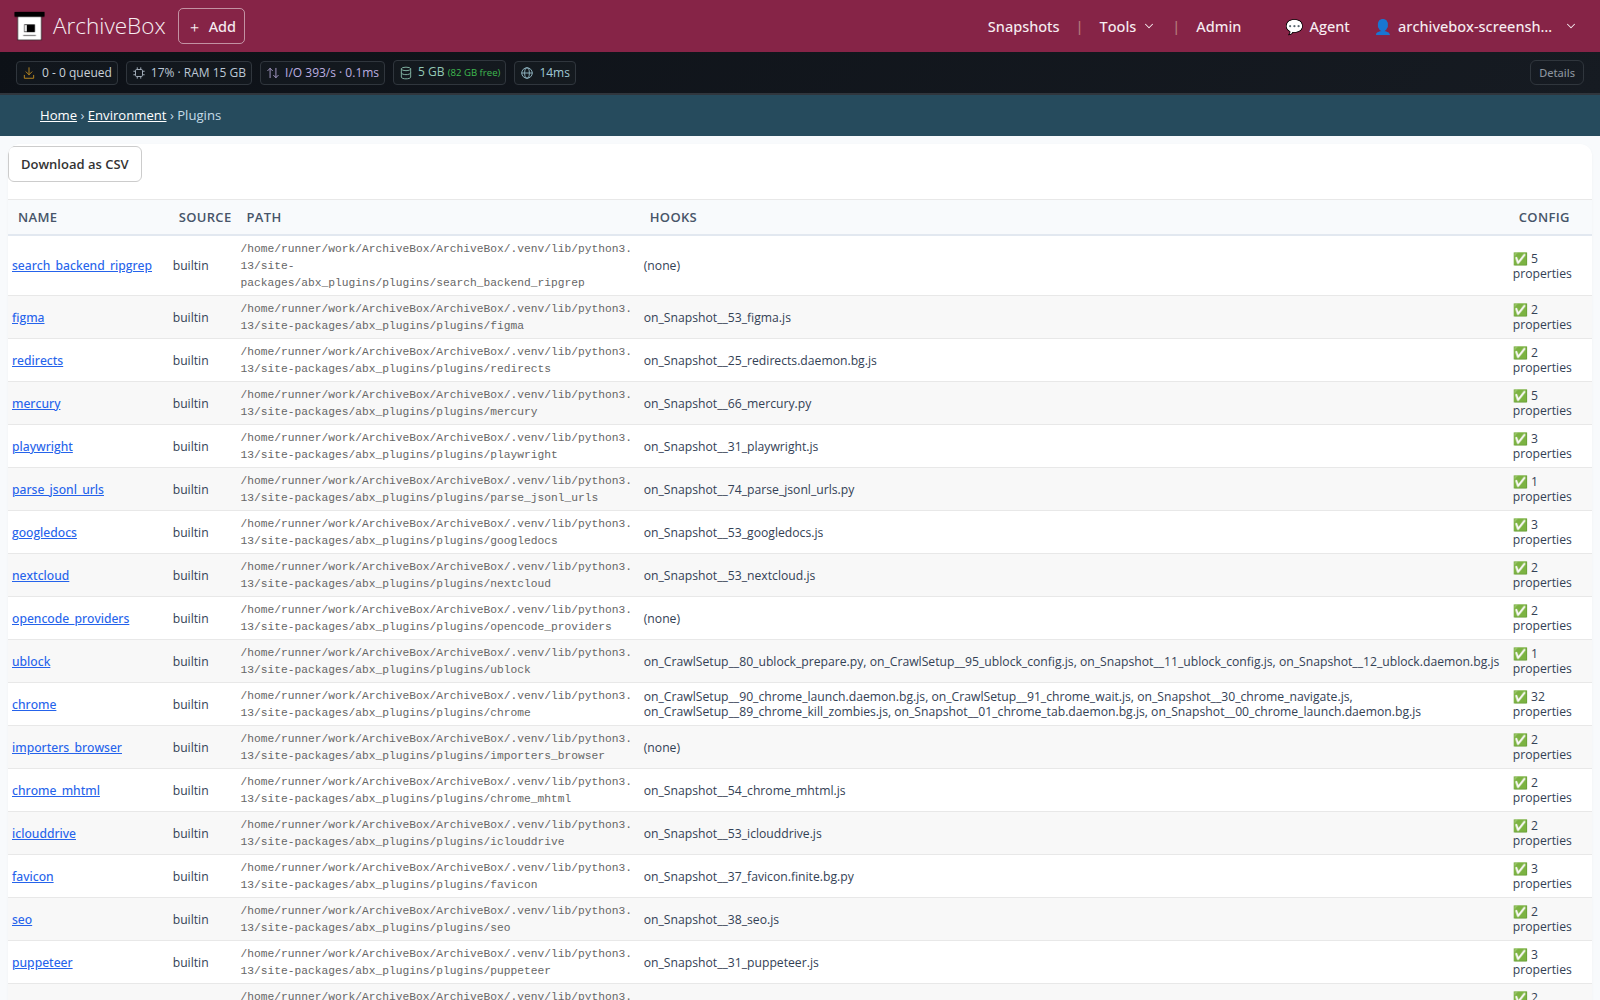
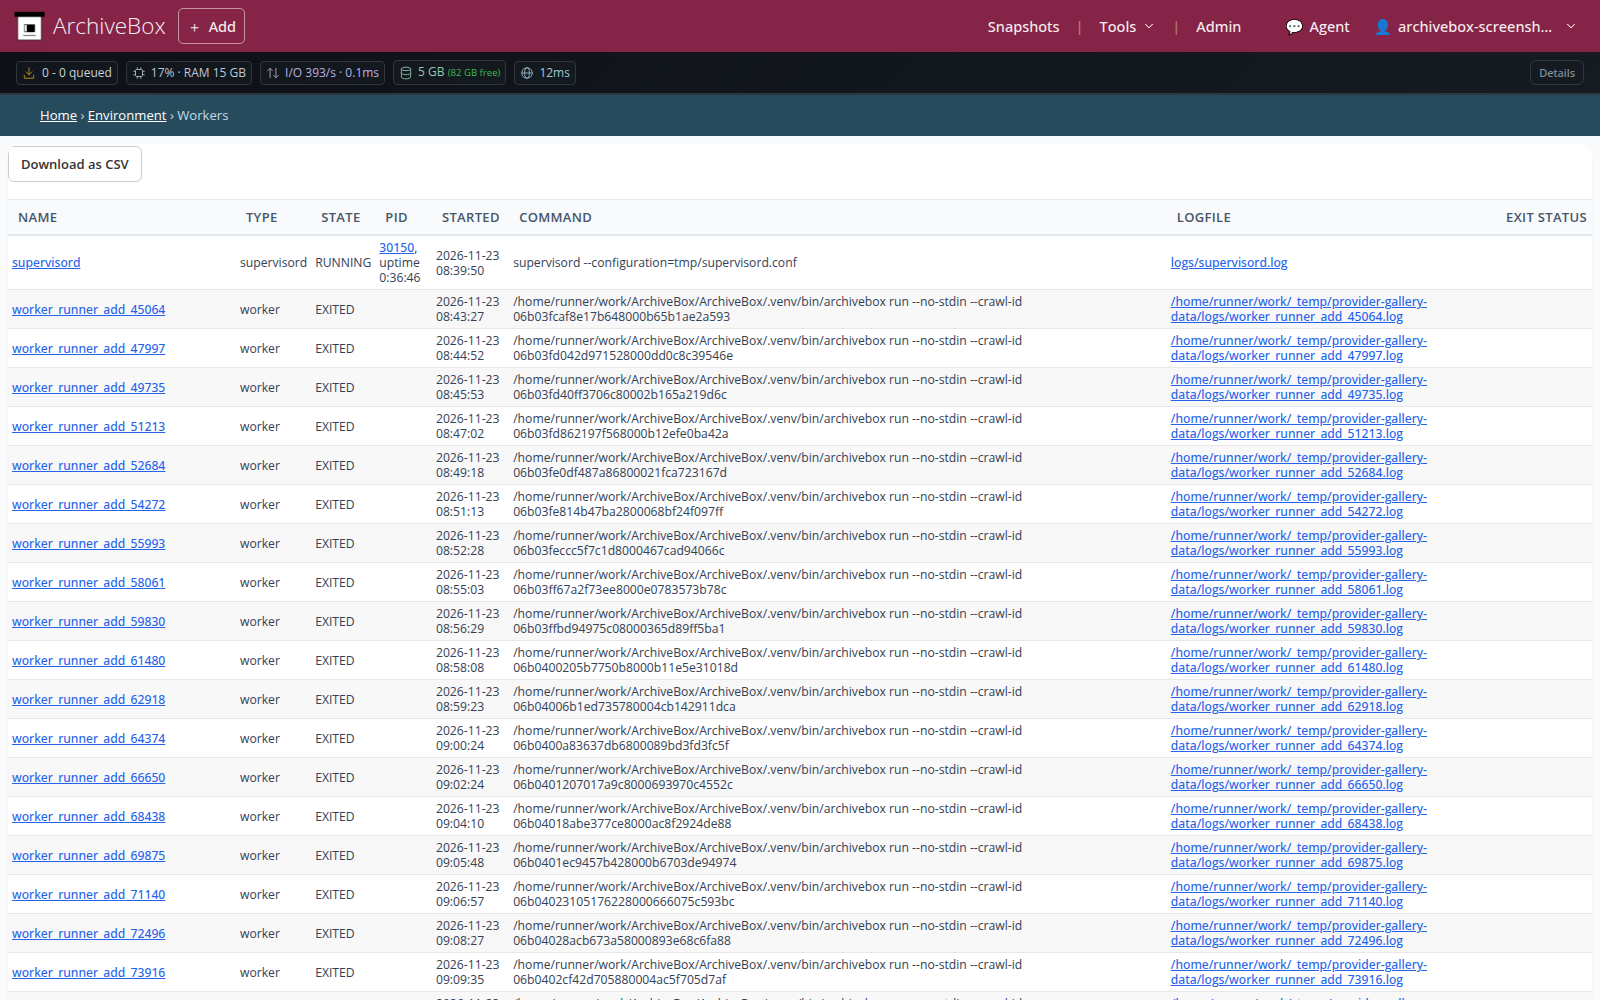



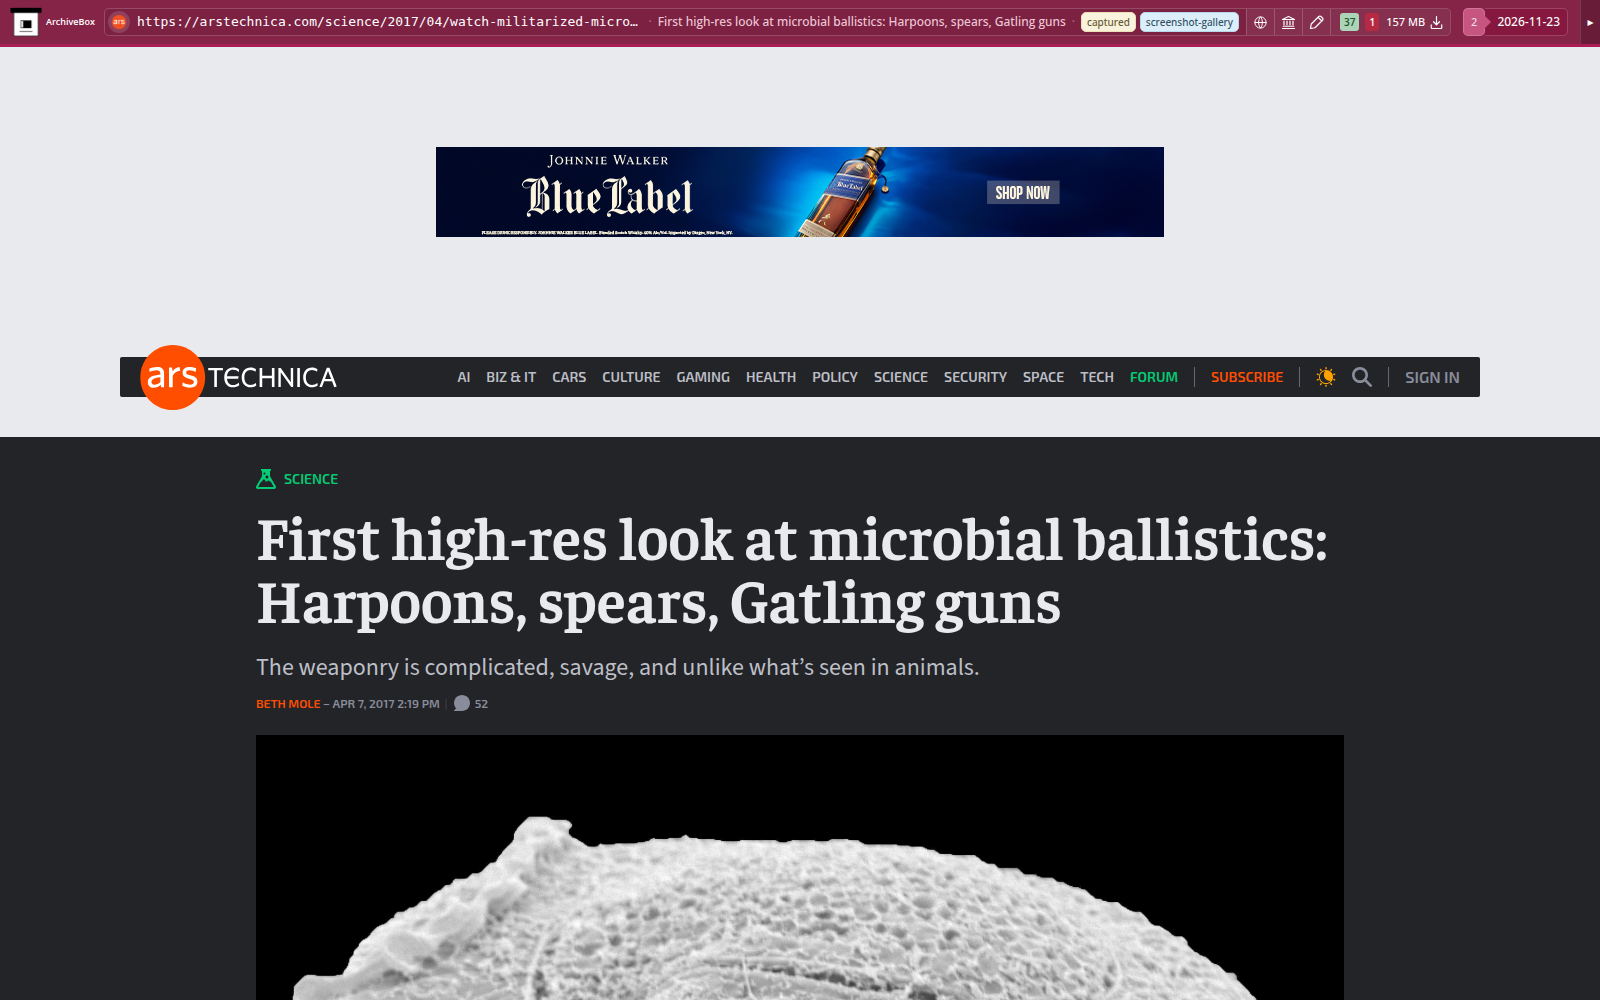


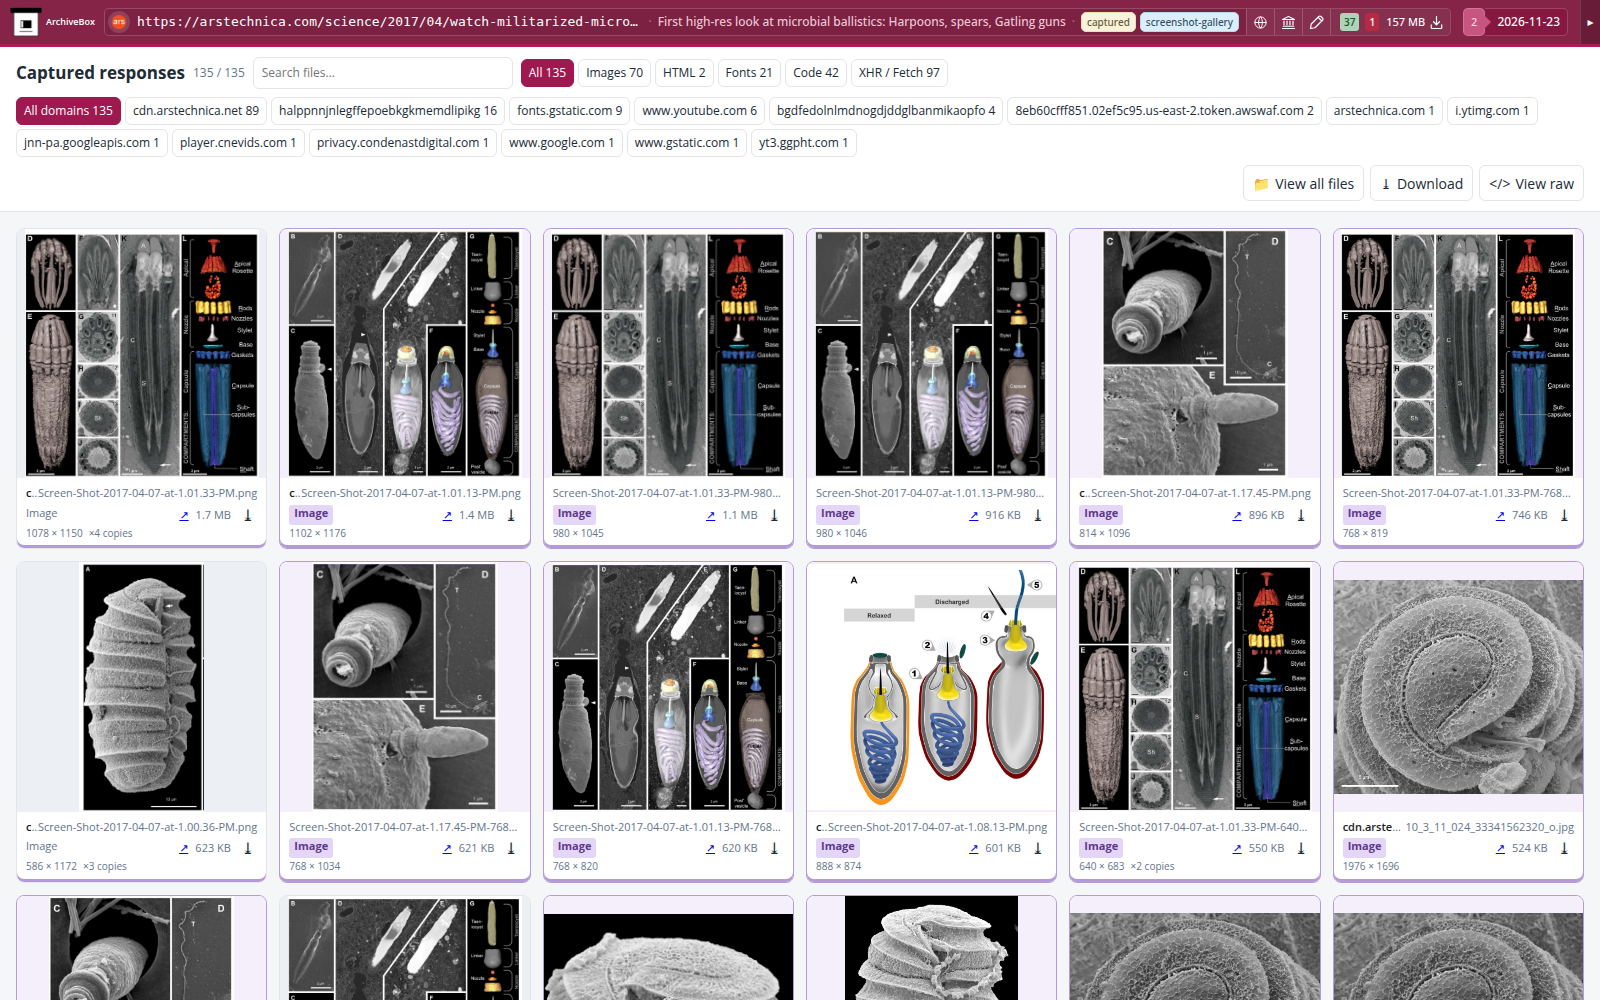
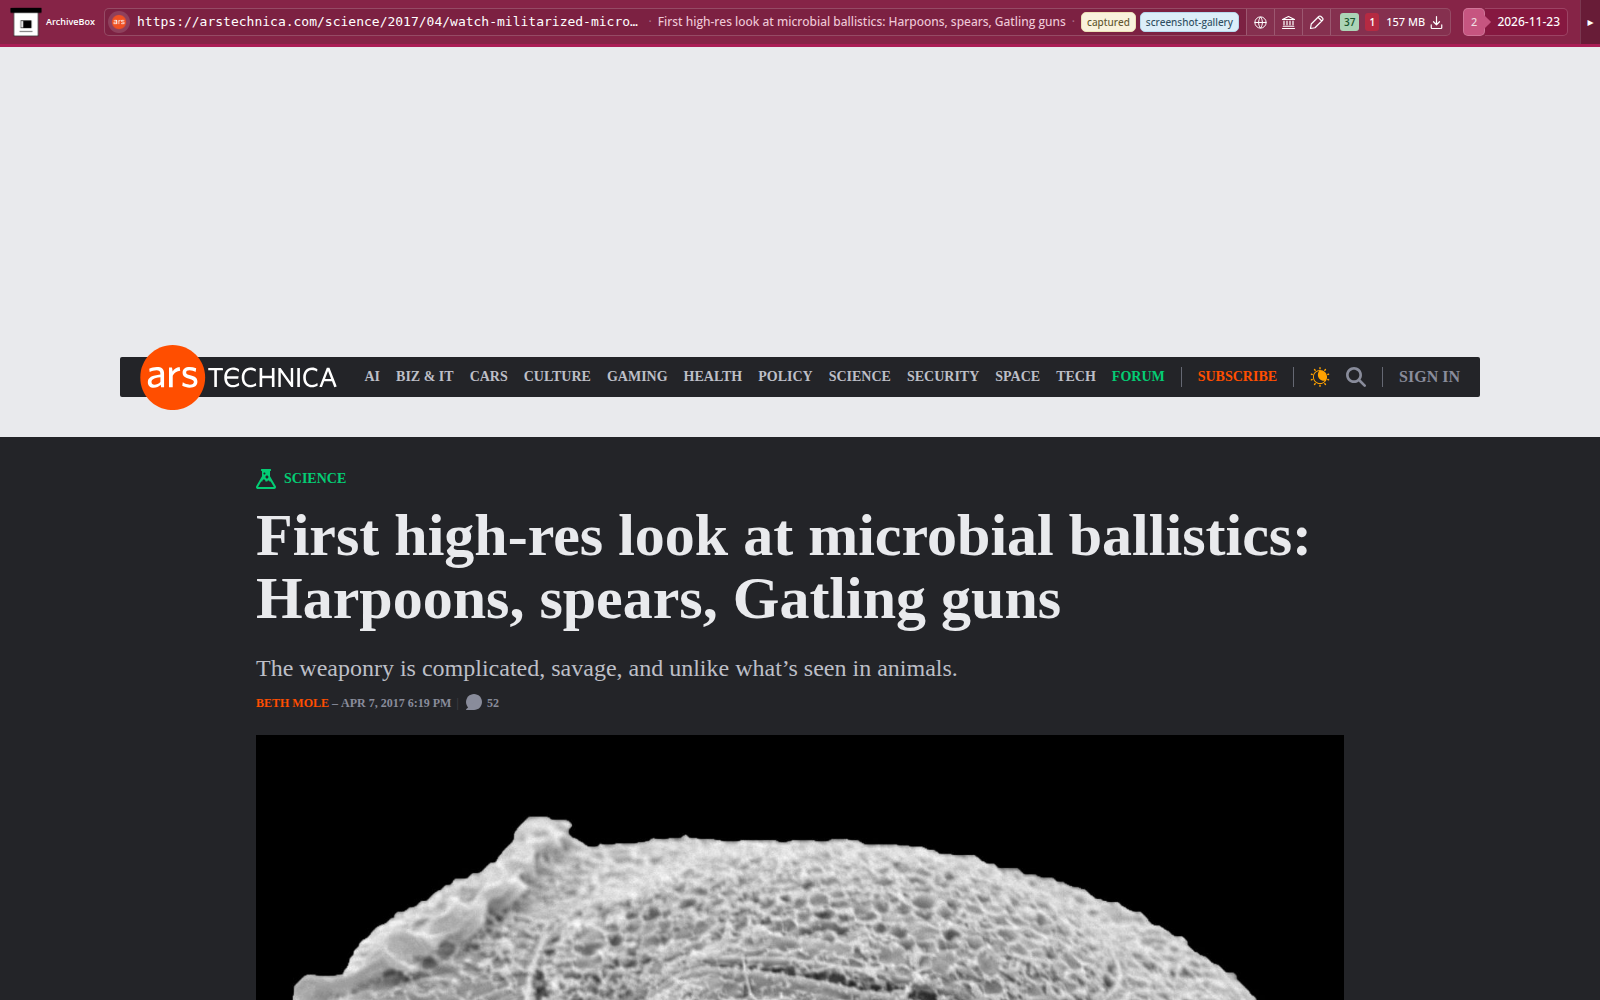


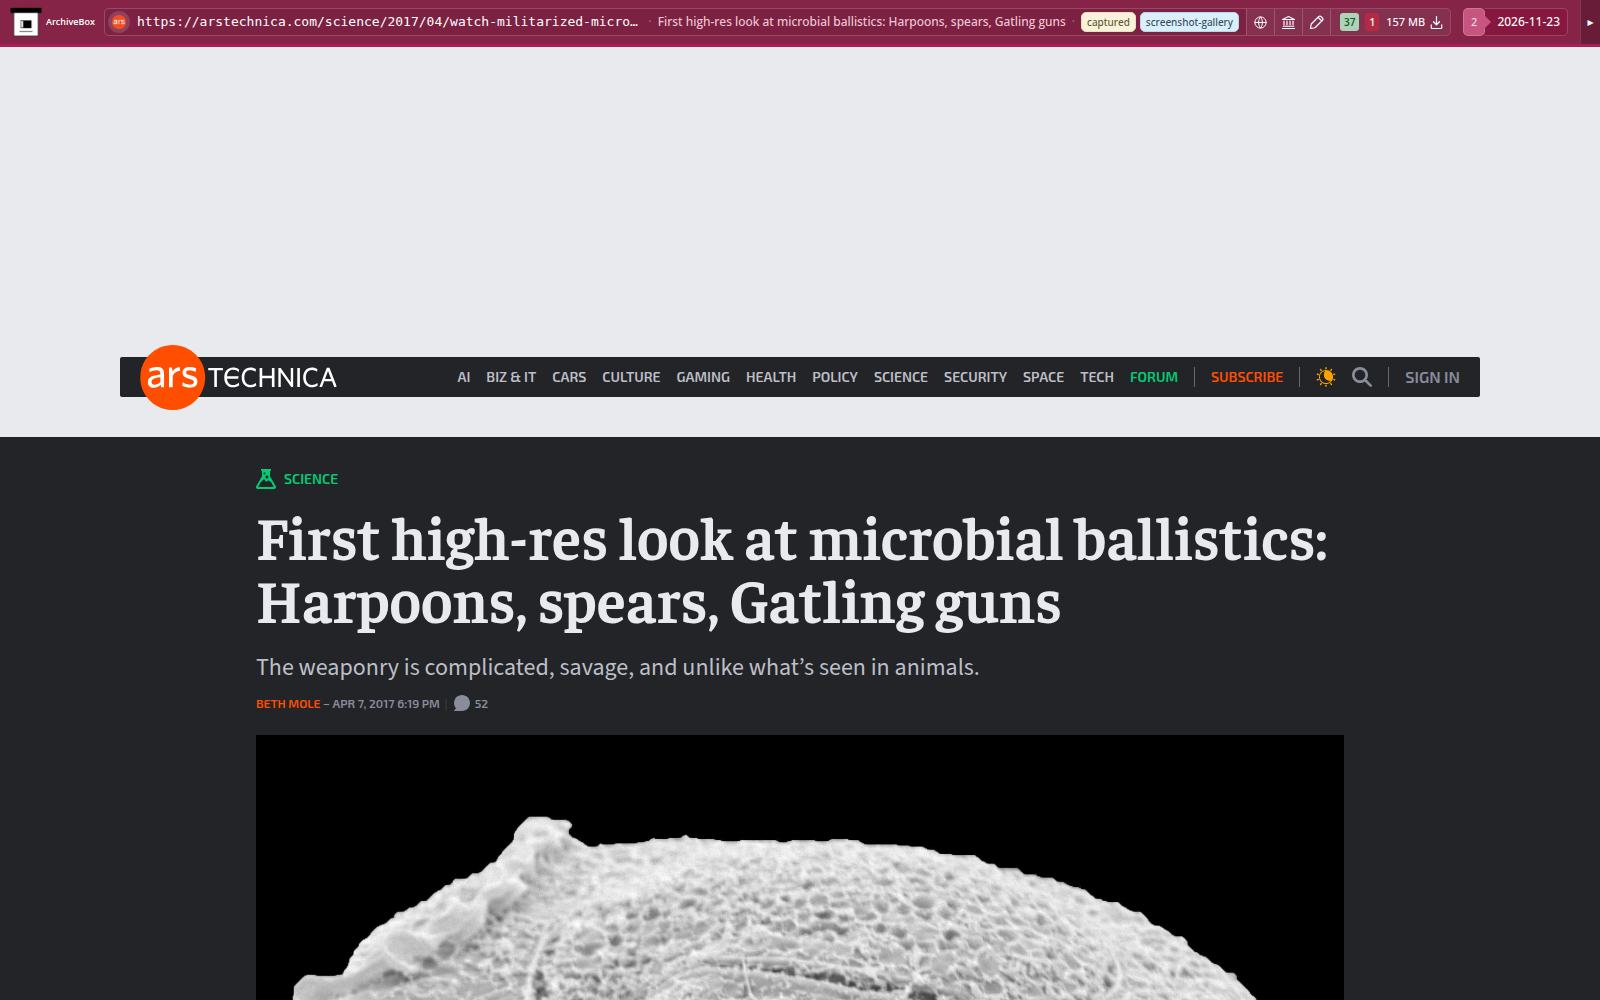
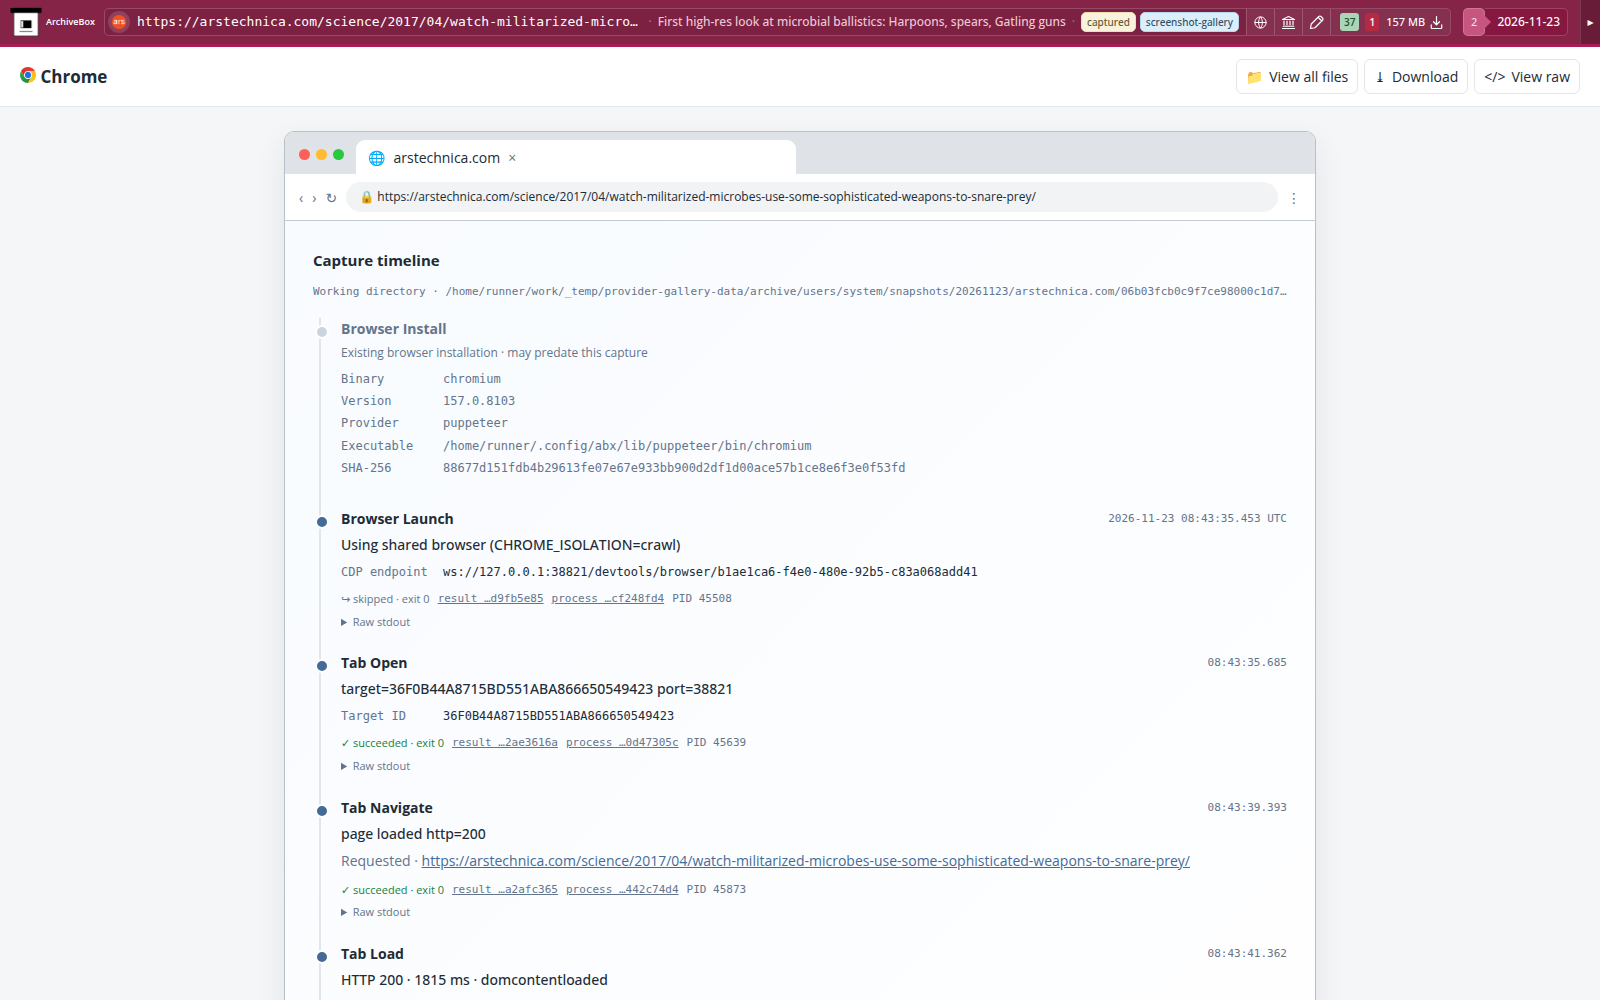
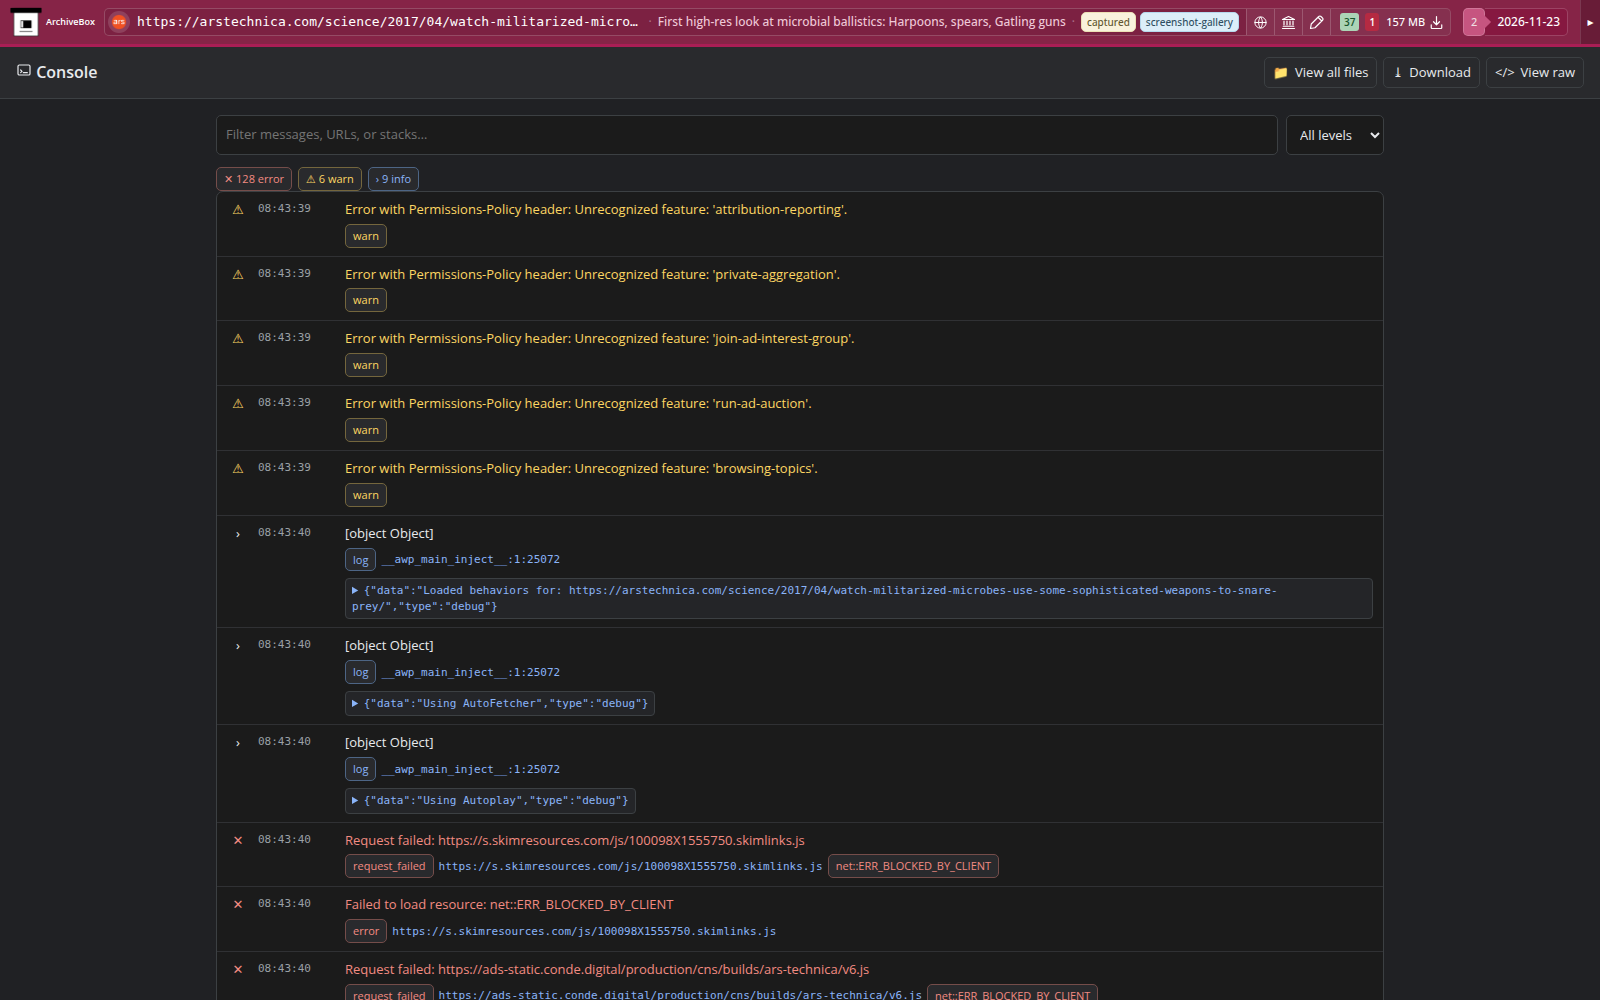
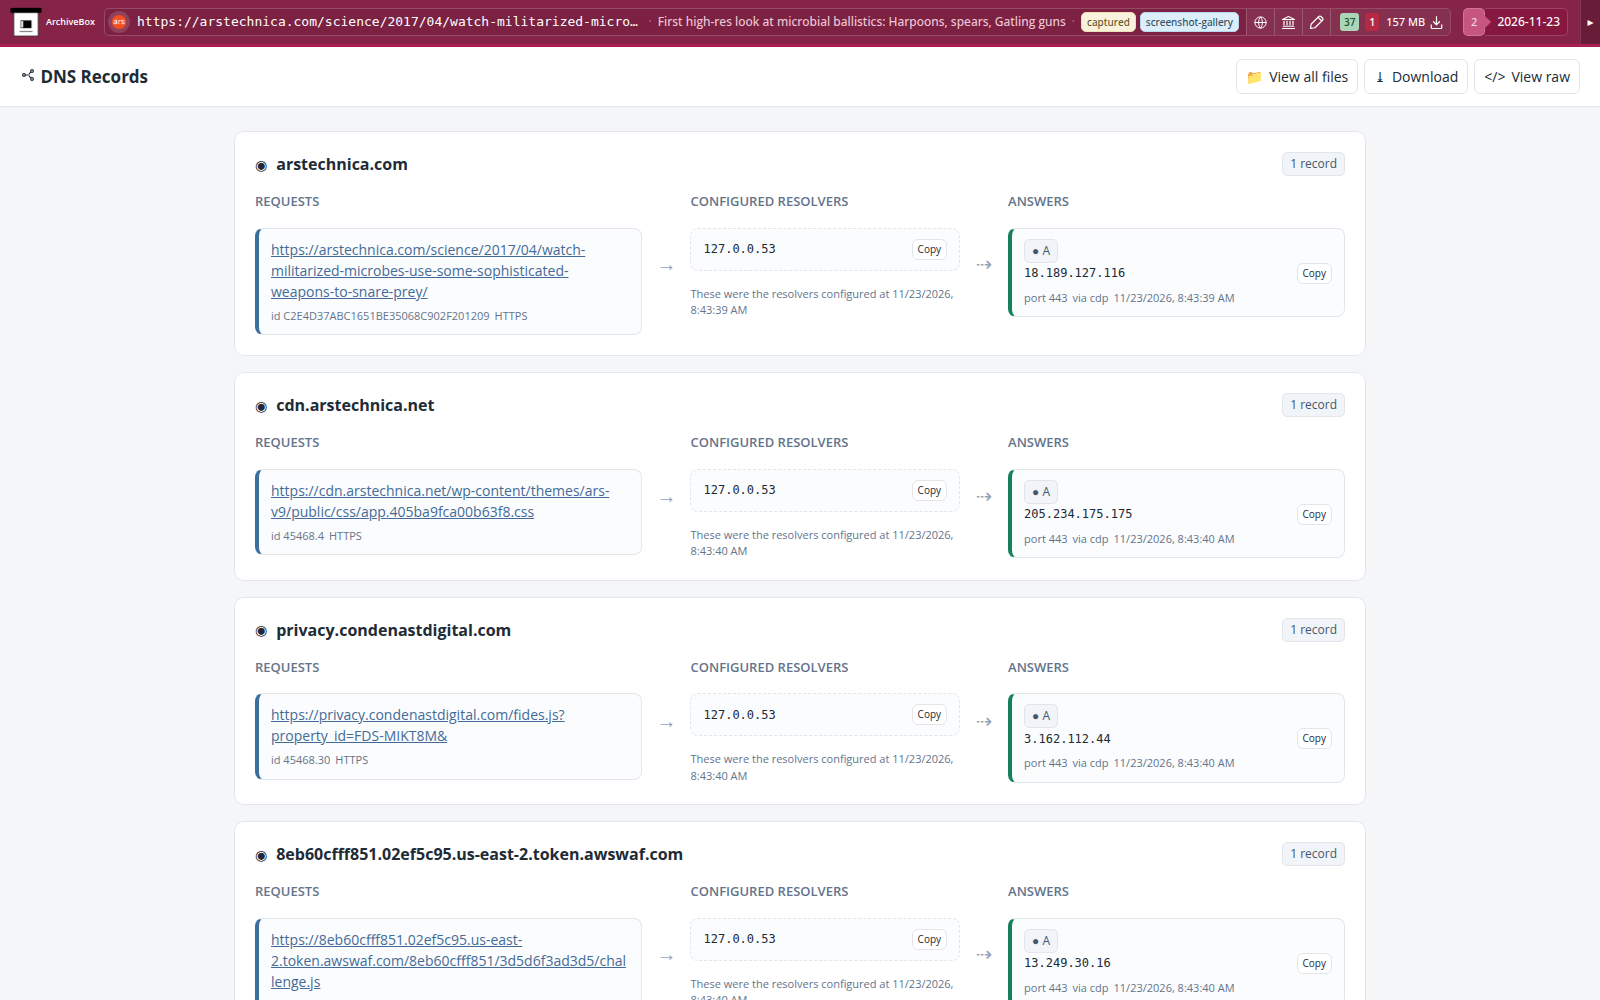

Pourquoi ArchiveBox
Collectez des signets pour les lire plus tard ou conservez des preuves pour des affaires juridiques avec des captures vérifiables de notre Plugin de signature TLSNotary.
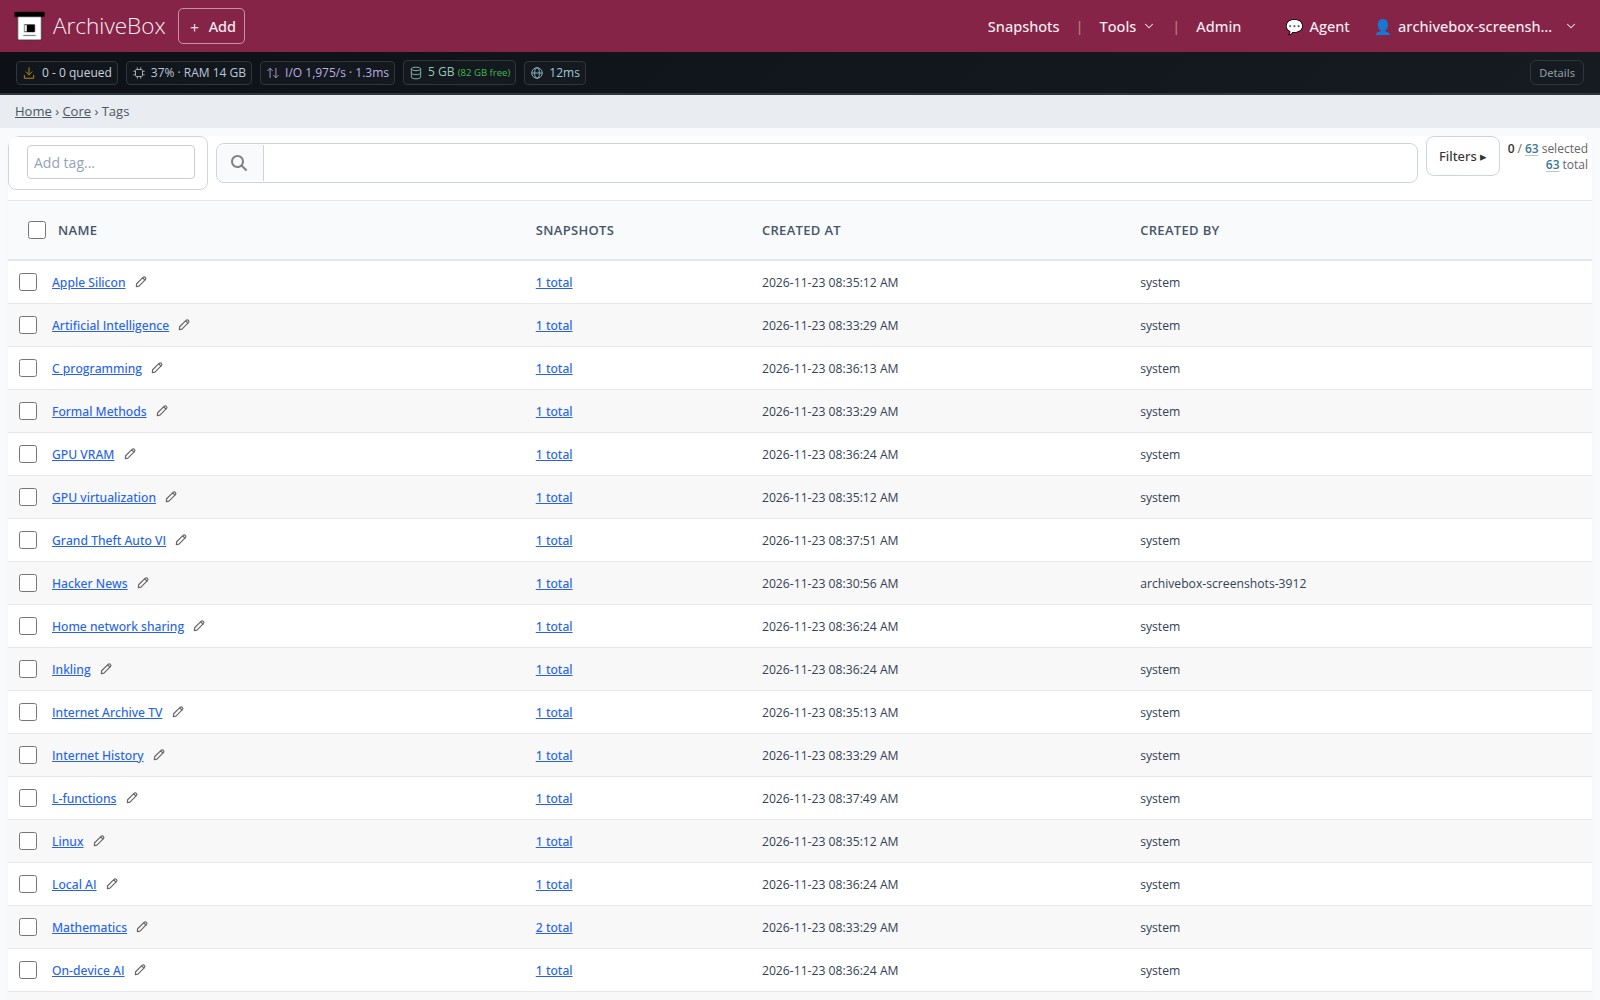
Organisez votre collection avec des balises et trouvez ce dont vous avez besoin grâce à la recherche en texte intégral optimisée par Sonic et Ripgrep.
Extrayez automatiquement l'audio, la vidéo, les archives git, les messages du forum, les métadonnées SEO, etc. fichiers ordinaires vous pouvez ouvrir et réutiliser.
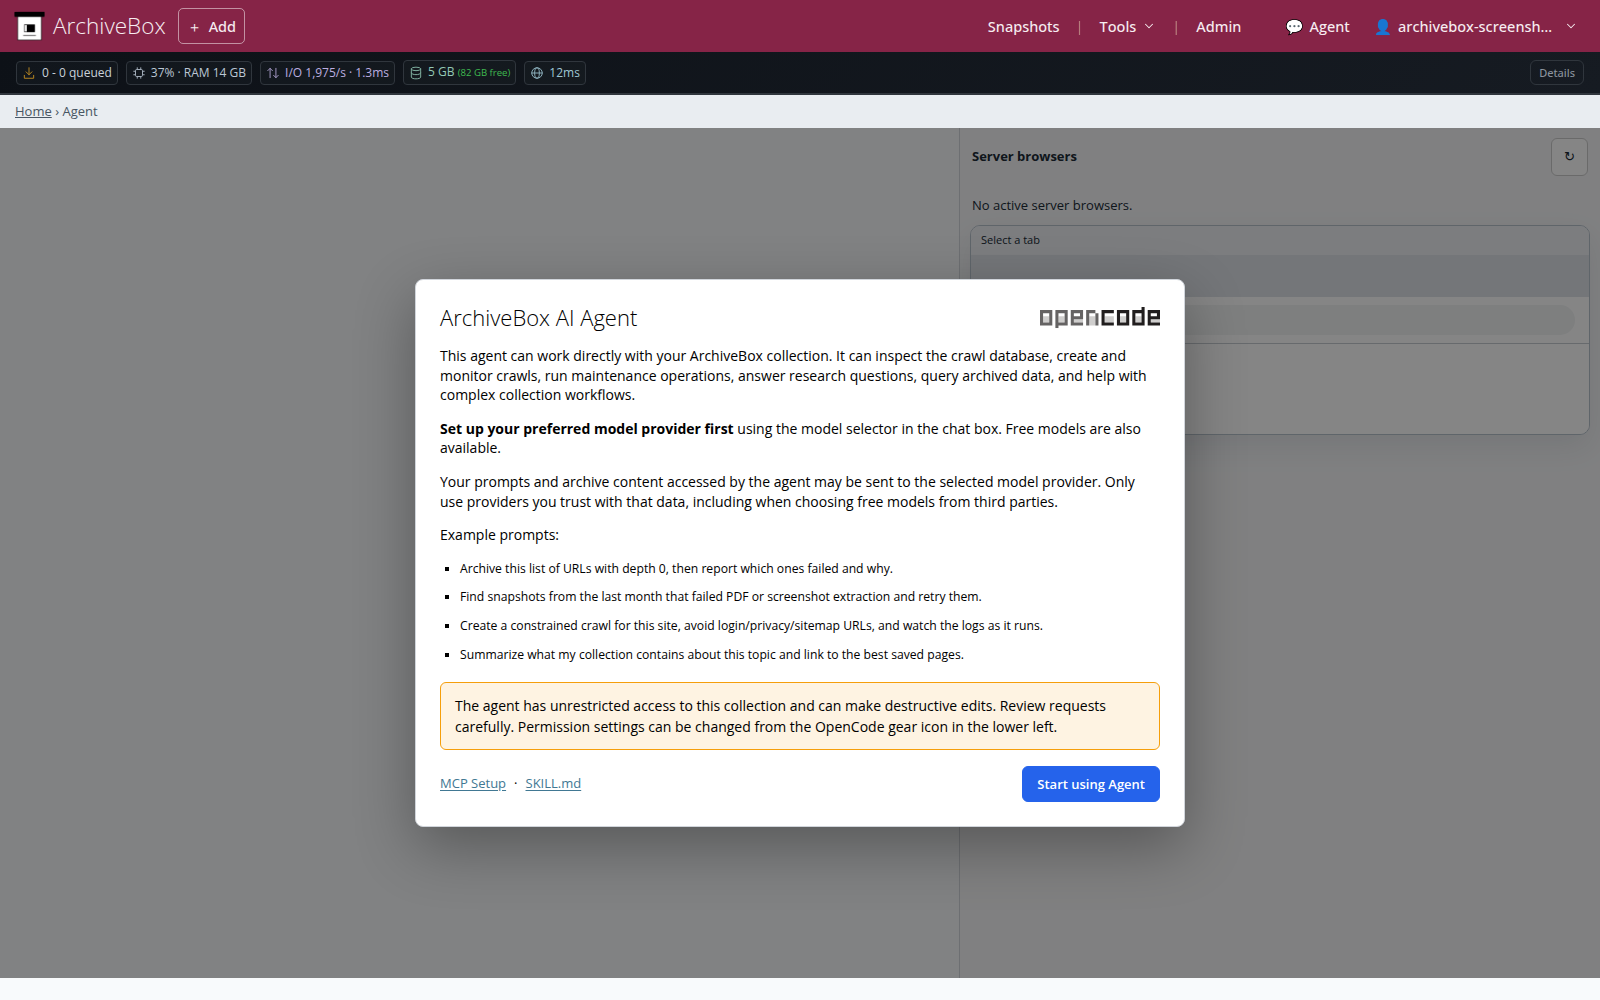
Dites à votre IA d'inspecter une page avec abx-dl, extrayez un flux RSS toutes les 24 heures ou orchestrez des analyses complexes MCP et le REST API.
Pour qui c'est
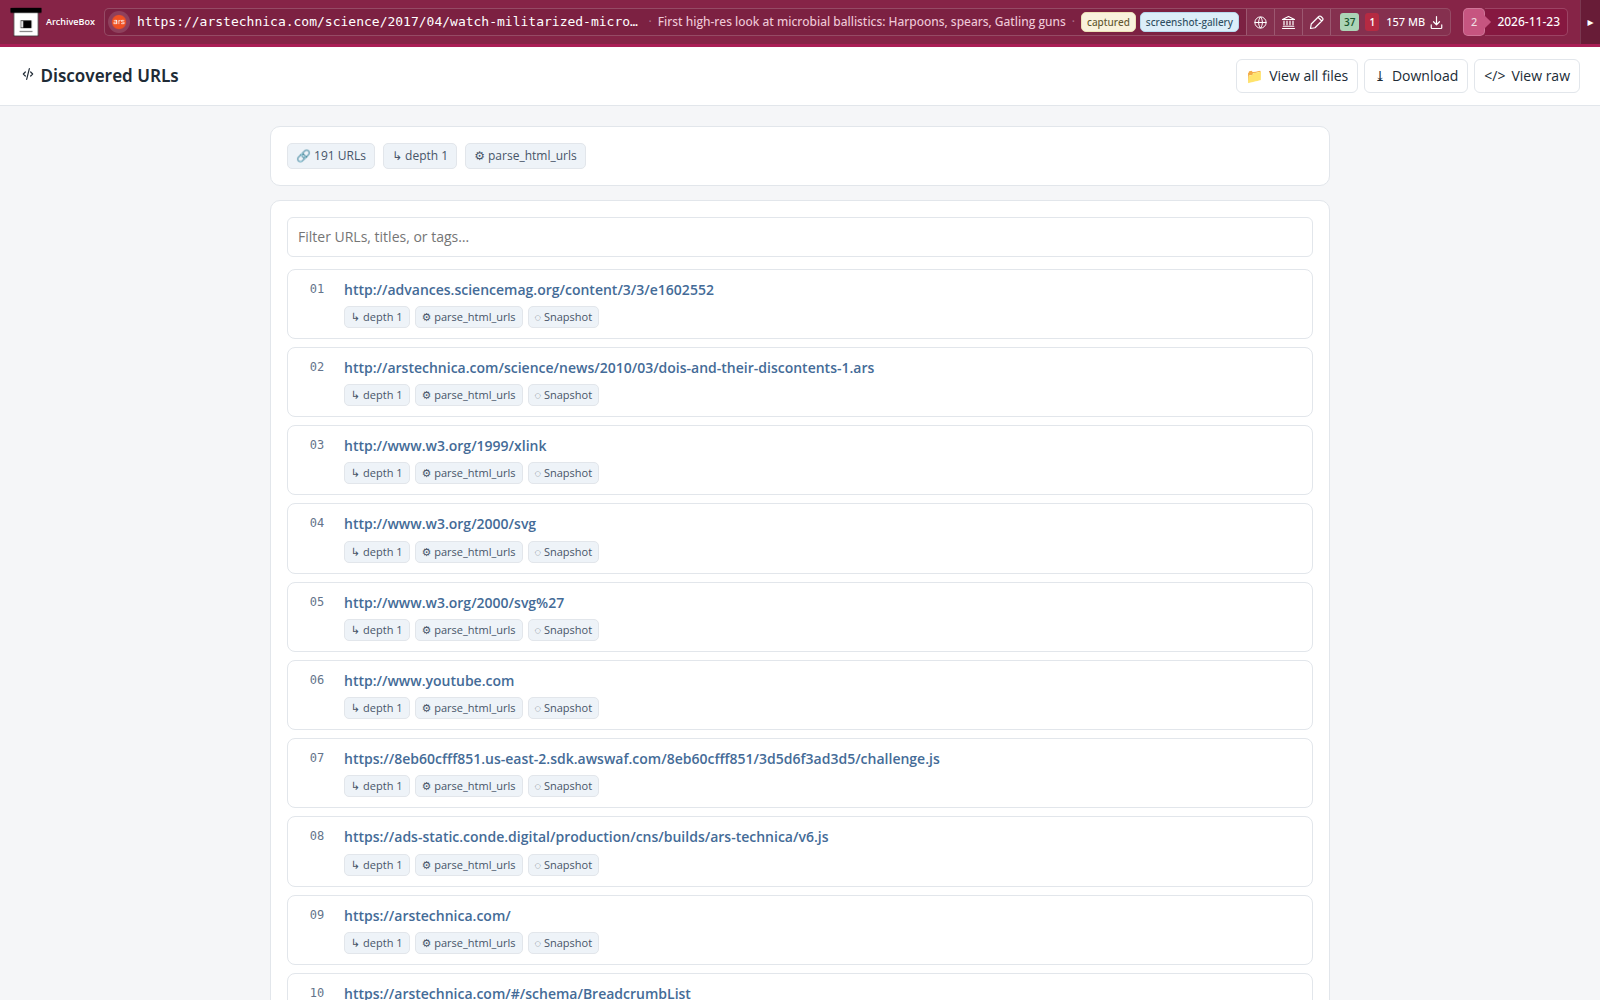
Enregistrez les favoris, l'historique du navigateur, les flux RSS, les réseaux sociaux, le contenu des formulaires, les vidéos, les podcasts, la musique, les photos et les collections de connaissances personnelles.
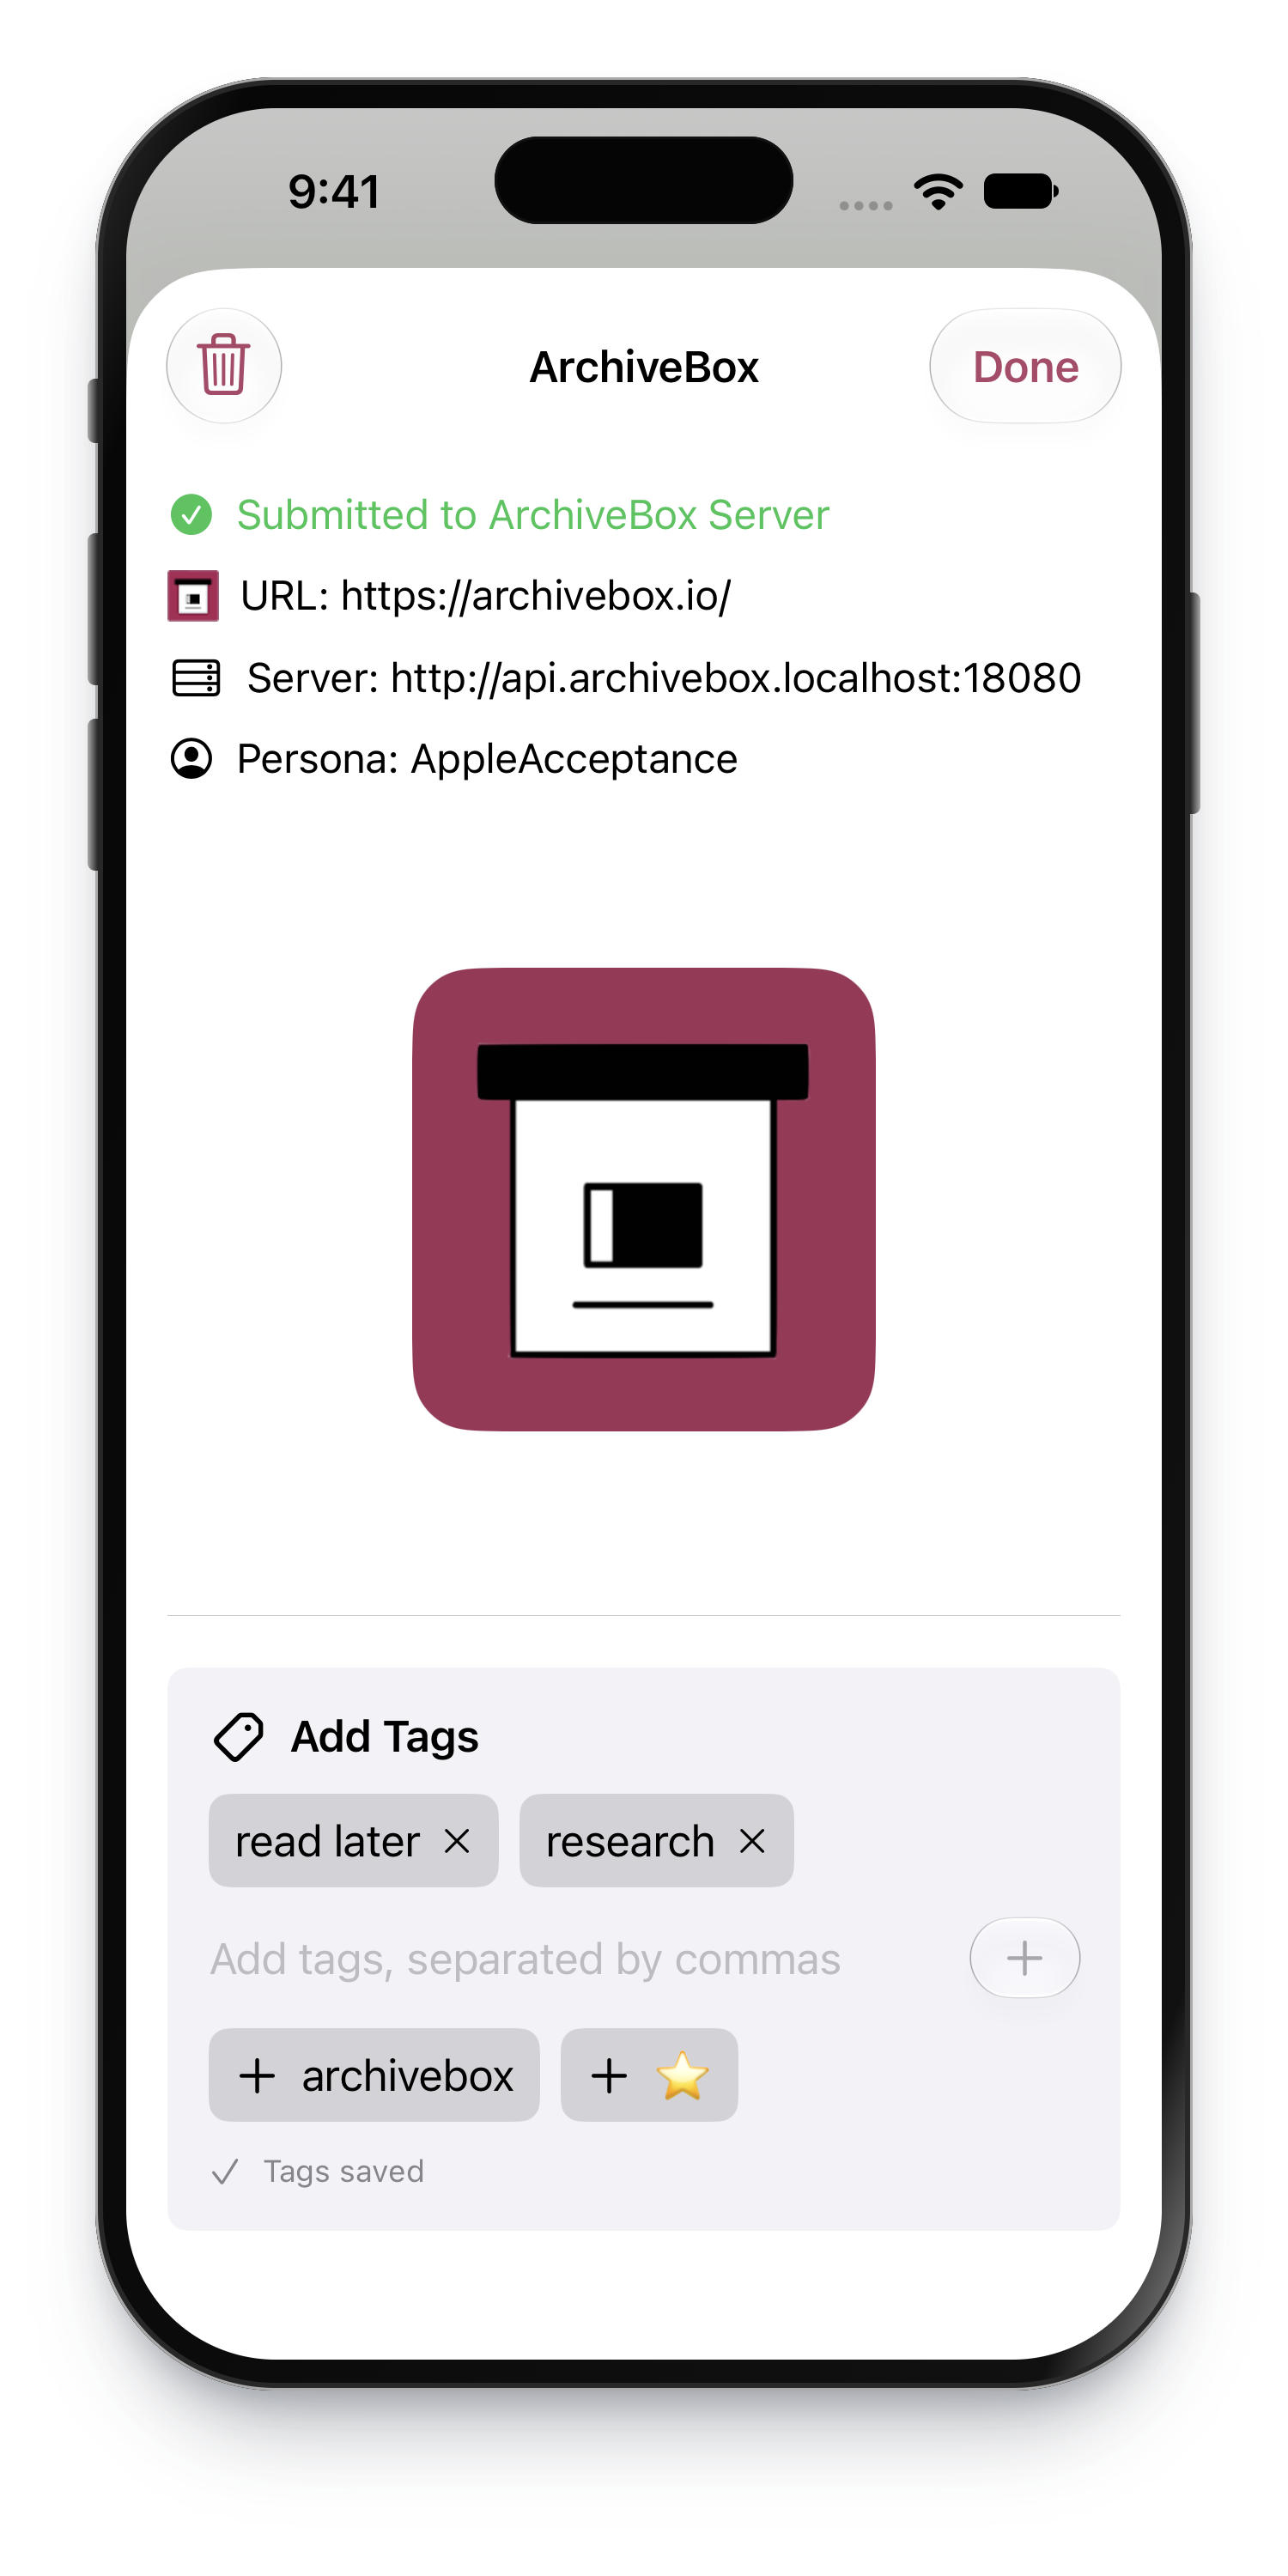

Conservez des copies des articles, des sources et des archives publiques, même après la modification ou la disparition des pages originales.
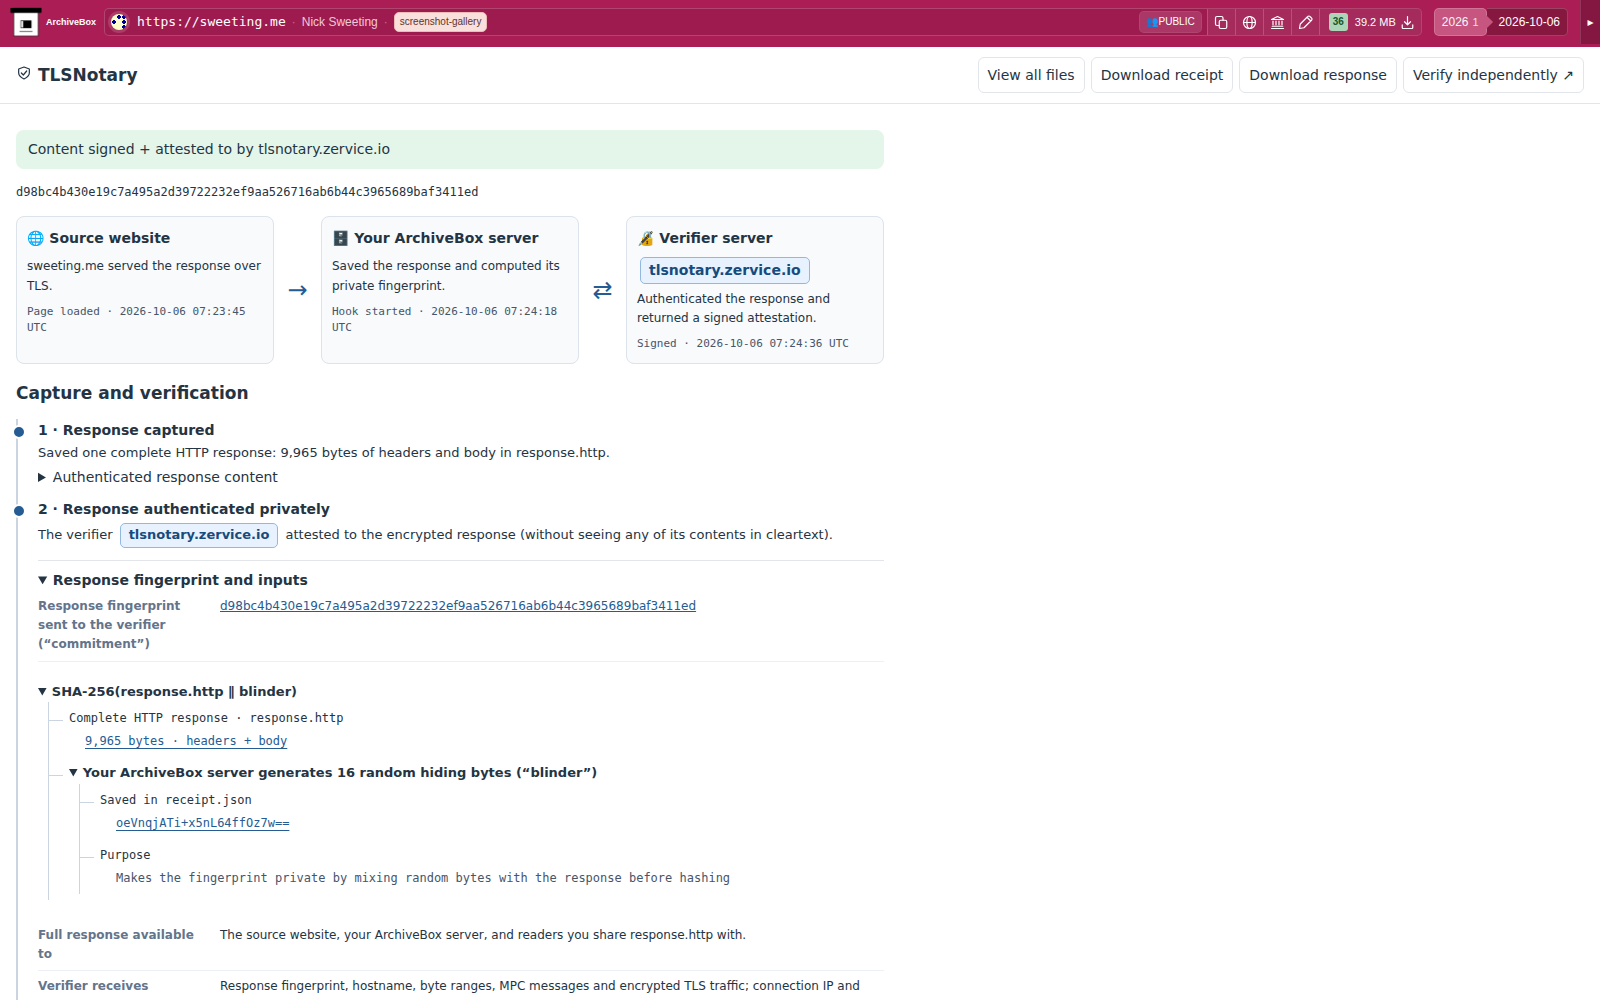
Soutenez OSINT, la recherche sur les réseaux sociaux, les agents de recherche basés sur l'IA, les bibliothèques, les gouvernements et les équipes de constitution de collections.
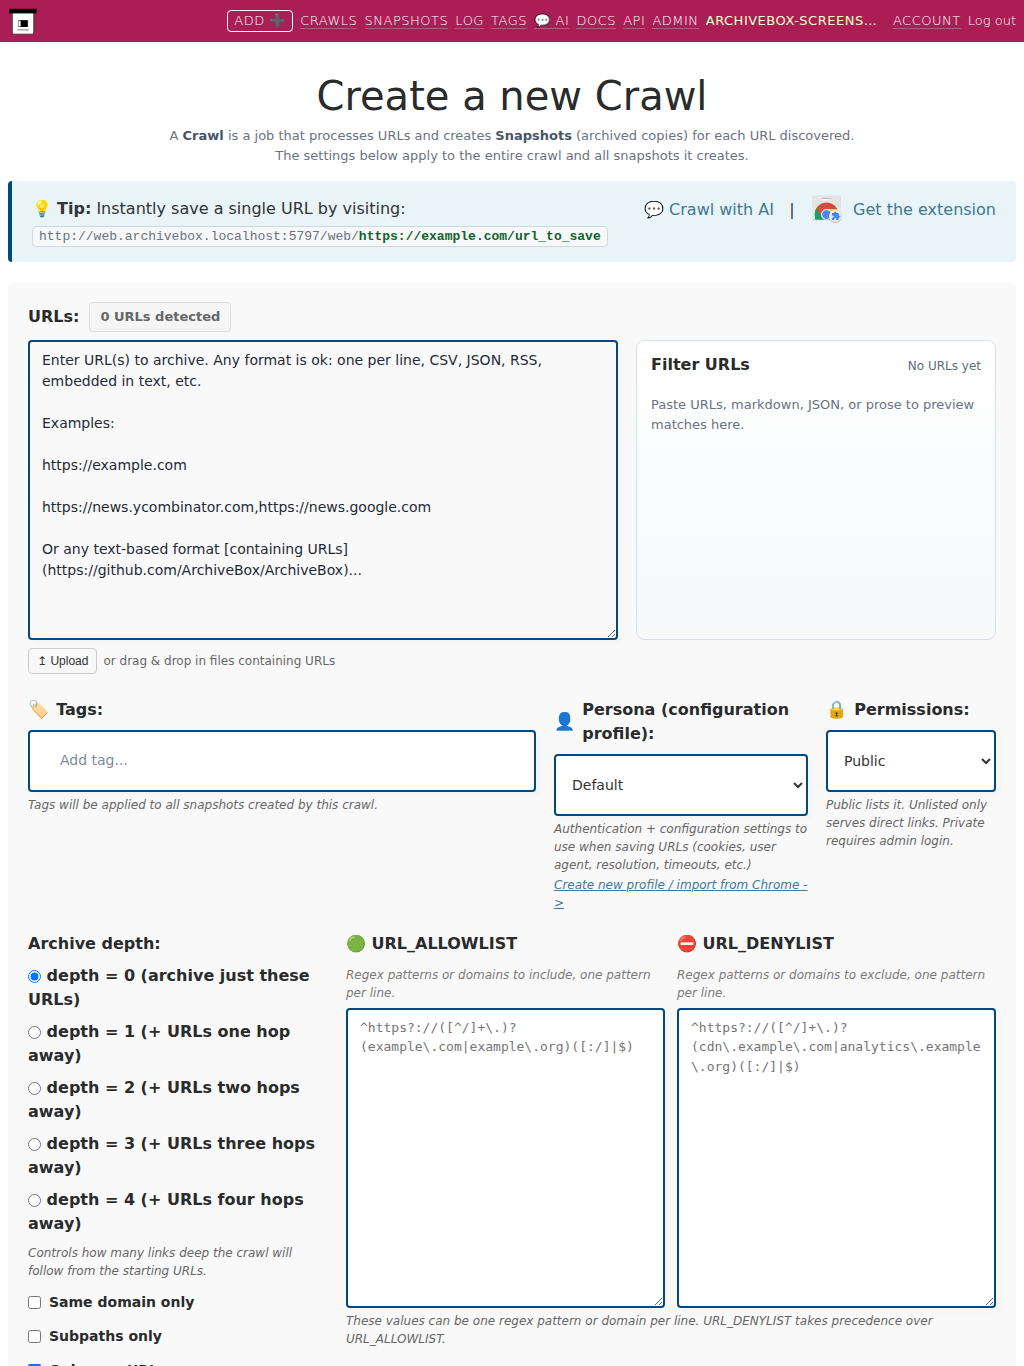
Obtenir ArchiveBox
Choisissez comment vous souhaitez exécuter vos archives. Docker Compose est recommandé pour la plupart des installations.
 Docker
 pip / uv
 apt
 brew
 Autres systèmes d'exploitation
 curl | sh
 Hébergement cloud
 Extension du navigateur
Ouvrez le lien TestFlight sur votre iPhone ou iPad pour installer ArchiveBox.
Le guide de première exécution vous aide à choisir un serveur ou à sélectionner J'ai déjà un serveur. Scannez le code QR de connexion depuis ArchiveBox Server.app sur votre Mac, ou saisissez l'URL de votre serveur et la clé API.
Dans Safari ou une autre application, choisissez Partager → ArchiveBox. Votre serveur enregistre la page afin que vous puissiez la parcourir depuis votre téléphone.
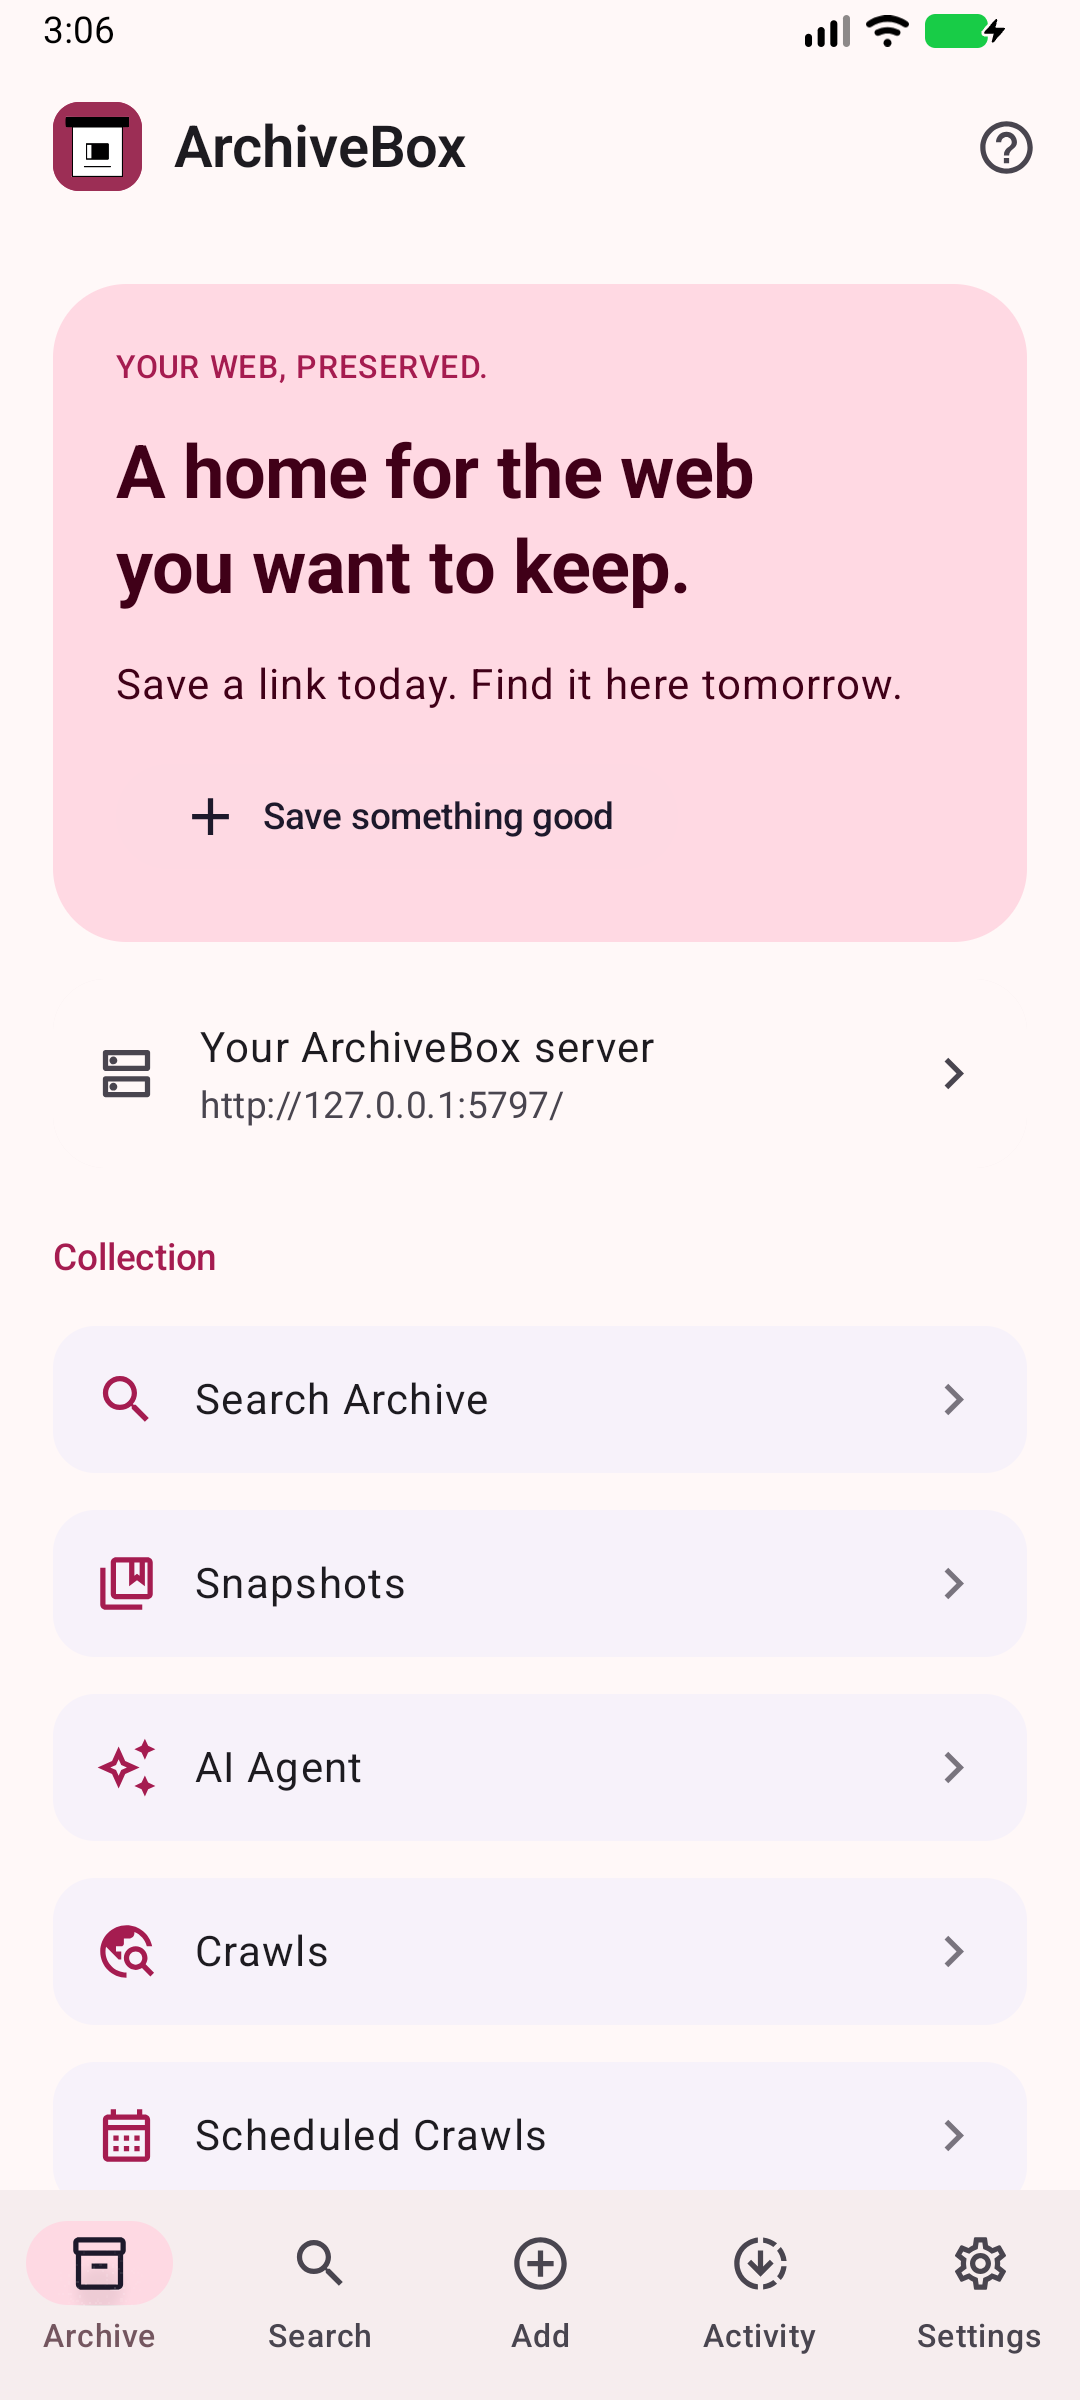
Les APK bêta d’Android apparaîtront ici une fois publiés. Ouvrez l'APK et autorisez l'installation depuis votre navigateur si Android vous le demande.
Utilisez le guide de première exécution pour choisir un serveur ou sélectionnez J'ai déjà un serveur. Dans Paramètres de connexion, saisissez l'URL de votre serveur et la clé API, puis vérifiez la connexion.
Choisir Partager → ArchiveBox depuis votre navigateur ou une autre application, ajoutez des balises et enregistrez. Gardez votre serveur accessible pour enregistrer et parcourir les pages.
 ArchiveBox.app
 Applications
Déplacez-le vers Applications et ouvrez-le.
Choisir Configurer sur ce Mac dans le guide de configuration, puis téléchargez et ouvrez ArchiveBox Server.app. Vous avez déjà un serveur ? Connectez-vous avec son URL et sa clé API.
Utilisez le Interface utilisateur Web, REST API, ou CLI. Connectez le application mobile, extension de navigateur, et d'autres clients utilisant l'URL de votre serveur et la clé API.
ArchiveBoxTélécharger Docker Bureau et démarrez-le sur votre ordinateur. Laissez Docker fonctionner pendant que vous utilisez ArchiveBox.
Ouvrez le programme d'installation, lancez ArchiveBox et créez votre compte administrateur. Le premier lancement prépare votre collection locale.
Ajoutez une URL dans l'application pour archiver votre première page.
 Docker Desktop
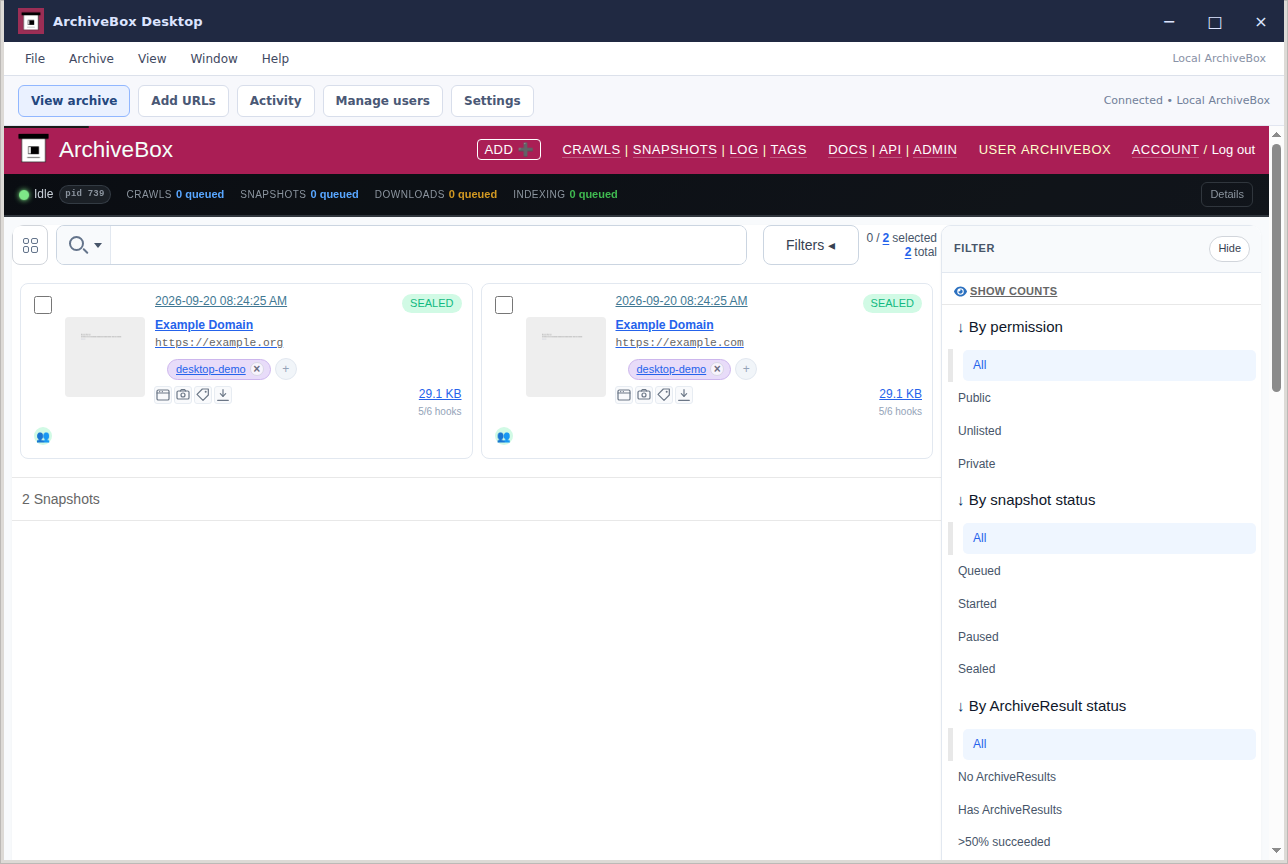
Télécharger Docker Bureau et démarrez-le sur votre ordinateur. Laissez Docker fonctionner pendant que vous utilisez ArchiveBox.
Ouvrez le programme d'installation, lancez ArchiveBox et créez votre compte administrateur. Le premier lancement prépare votre collection locale.
Ajoutez une URL dans l'application pour archiver votre première page.
Docker ComposeArchiveBoxdocker-compose.ymlCompose conserve vos paramètres dans un seul fichier et facilite les mises à jour. Installer Docker, puis créez un répertoire et récupérez le fichier config.
mkdir -p ~/archivebox/data && cd ~/archivebox
curl -fsSL 'https://docker-compose.archivebox.io' > docker-compose.ymldocker compose pull
docker compose up -d --waitUne nouvelle collection s'initialise automatiquement.
Ouvrir l'interface utilisateur d'administration pour créer votre premier compte administrateur et terminer l'assistant de configuration. Sur un serveur distant, ouvrez /admin/ sur son nom d'hôte ou son IP à la place.
docker compose exec archivebox archivebox add 'https://example.com'Vous avez un fichier Compose ? Convertissez-le en docker run commandes avec Decomposerize.
Installer Docker d'abord.
mkdir -p ~/archivebox/data && cd ~/archivebox/data
docker run -d --name archivebox -v "$PWD:/data" -p 5797:5797 archivebox/archivebox:devOuvrir l'interface utilisateur d'administration pour créer votre premier compte administrateur et terminer l'assistant de configuration. Sur un serveur distant, ouvrez /admin/ sur son nom d'hôte ou son IP à la place.
docker exec archivebox archivebox add 'https://example.com'Installer UV d'abord.
uv tool install --python 3.13 --prerelease explicit --upgrade 'archivebox>=0.9.0rc0,<0.10'
archivebox versionmkdir -p ~/archivebox/data && cd ~/archivebox/data
archivebox init
archivebox install
archivebox server 0.0.0.0:5797Ouvrir l'interface utilisateur d'administration pour créer votre premier compte administrateur et terminer l'assistant de configuration. Sur un serveur distant, ouvrez /admin/ sur son nom d'hôte ou son IP à la place.
Une fois Python 3.13 installé, créez un environnement virtuel et installez ArchiveBox :
python3.13 -m venv ~/.venvs/archivebox
source ~/.venvs/archivebox/bin/activate
python -m pip install --upgrade 'archivebox>=0.9.0rc0,<0.10'
archivebox version
Suivez ensuite les étapes 2 et 3 ci-dessus. Dans chaque nouveau terminal, exécutez source ~/.venvs/archivebox/bin/activate avant d'utiliser archivebox.
aptArchiveBoxecho 'deb [trusted=yes] https://archivebox.github.io/debian-archivebox dev main' | sudo tee /etc/apt/sources.list.d/archivebox.list
sudo apt update
sudo apt install archivebox
(cd /tmp && archivebox version)mkdir -p ~/archivebox/data && cd ~/archivebox/data
archivebox init
sudo archivebox install
archivebox server 0.0.0.0:5797Ouvrir l'interface utilisateur d'administration pour créer votre premier compte administrateur et terminer l'assistant de configuration. Sur un serveur distant, ouvrez /admin/ sur son nom d'hôte ou son IP à la place.
HomebrewArchiveBoxInstaller Homebrew d'abord. Exécutez ces commandes en tant qu'utilisateur normal, sans sudo.
brew tap archivebox/archivebox
brew trust archivebox/archivebox
brew install archivebox
archivebox versionmkdir -p ~/archivebox/data && cd ~/archivebox/data
archivebox init
archivebox install
archivebox server 0.0.0.0:5797Ouvrir l'interface utilisateur d'administration pour créer votre premier compte administrateur et terminer l'assistant de configuration. Sur un serveur distant, ouvrez /admin/ sur son nom d'hôte ou son IP à la place.
Arch Linux FreeBSD
 RienArchiveBox
Les packages communautaires peuvent être en retard par rapport aux versions Docker et Python.
yay -S archiveboxFreeBSD (raccourci uv)
curl -fsSL 'https://get.archivebox.io' | bashnix-env --install archiveboxguix install archiveboxSuivez les instructions de configuration de votre package, puis utilisez le Guide d'utilisation de l'interface CLI pour initialiser et gérer vos archives.
curl get.archivebox.io
| shArchiveBoxcurl -fsSL 'https://get.archivebox.io' | bashTu peux lire le scénario avant de l'exécuter.
Suivez les instructions du programme d’installation pour commencer à utiliser votre collection.
Ouvrir l'interface utilisateur d'administration pour créer votre premier compte administrateur et terminer l'assistant de configuration. Sur un serveur distant, ouvrez /admin/ sur son nom d'hôte ou son IP à la place.
ArchiveBoxSuivez le guide d'installation de la plateforme, configurez le stockage persistant, puis ouvrez l'application pour terminer la configuration.
Pour TrueNAS, consultez le Notes de la plateforme README avant de choisir une intégration.
ArchiveBoxVérifiez les forfaits actuels du fournisseur, les versions prises en charge et les options de stockage.
Utilisez le flux de déploiement ArchiveBox du fournisseur, puis ouvrez votre instance pour créer un compte administrateur. Pour un VPS non géré, suivez le démarrage rapide de Docker Compose sur votre serveur.
 Enregistrez depuis votre navigateur
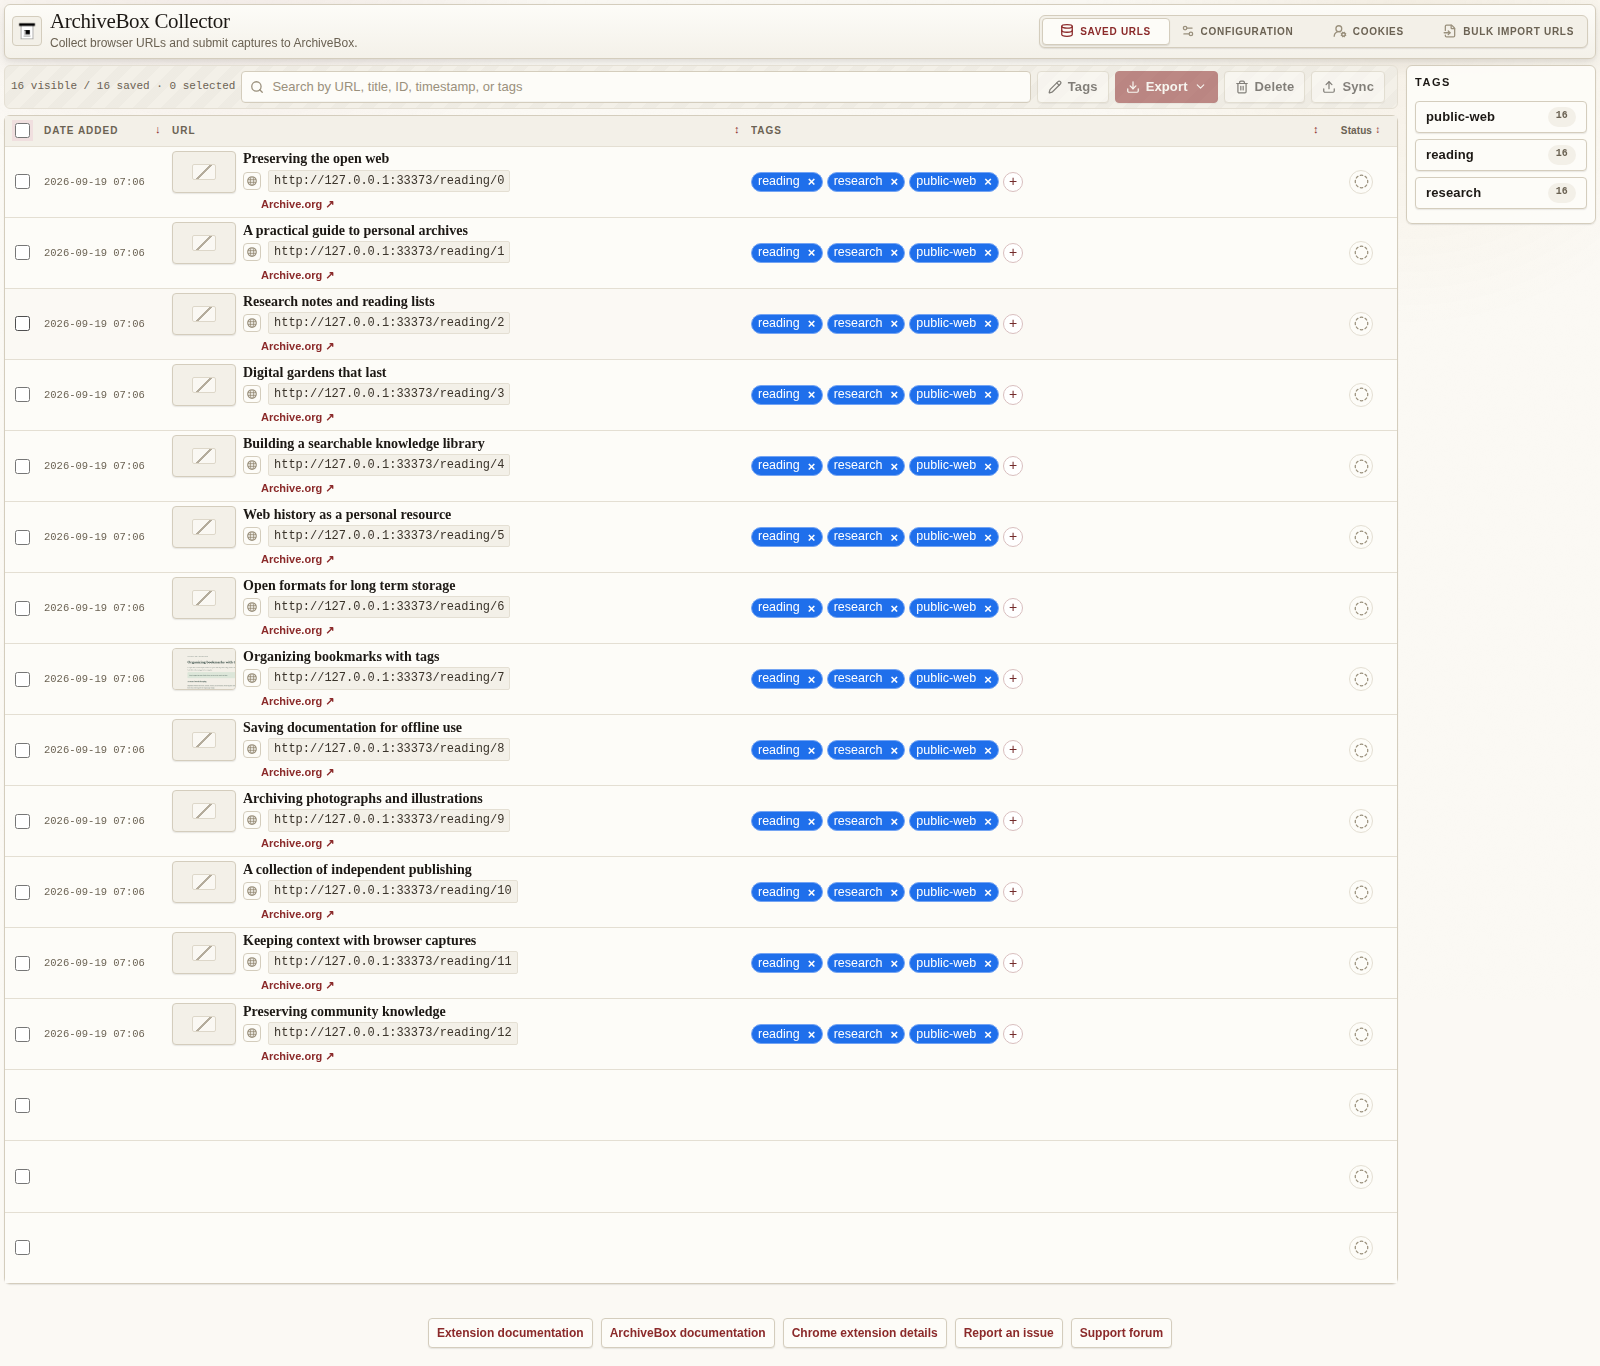
Ouvrez la page de configuration de l'extension, saisissez l'URL de votre serveur et la clé API, puis testez la connexion. Utilisez l'un des onglets d'installation du serveur si vous n'avez pas encore de serveur.
Ouvrez une page, cliquez sur l'extension ArchiveBox et ajoutez vos balises. Vous pouvez également importer des favoris et un historique à partir des options de l’extension.
Configuration




ArchiveBox peut être configuré via l'interface utilisateur d'administration, la CLI, ArchiveBox.conf, ou en important la configuration et les cookies depuis Chrome/d'autres navigateurs. Le même modèle de configuration fonctionne dans Docker, Docker Compose, les installations nues, les tâches planifiées et les exécutions CLI ponctuelles.
Utiliser TIMEOUT pour les réseaux lents, CHECK_SSL_VALIDITY pour les sites avec des certificats cassés, PUBLIC_INDEX, PUBLIC_SNAPSHOTS, et PUBLIC_ADD_VIEW pour la politique de publication et les paramètres de l'agent utilisateur du navigateur pour les sites qui bloquent les robots évidents.
$ configuration de la boîte d'archives                         # voir la configuration complète
$ configuration de la boîte d'archives --get CHROME_BINARY
$ configuration de la boîte d'archives --set TIMEOUT=240
$ configuration de la boîte d'archives --set PUBLIC_INDEX=False
$ env CHROME_BINARY=chromium archivebox ajouter 'https://example.com'
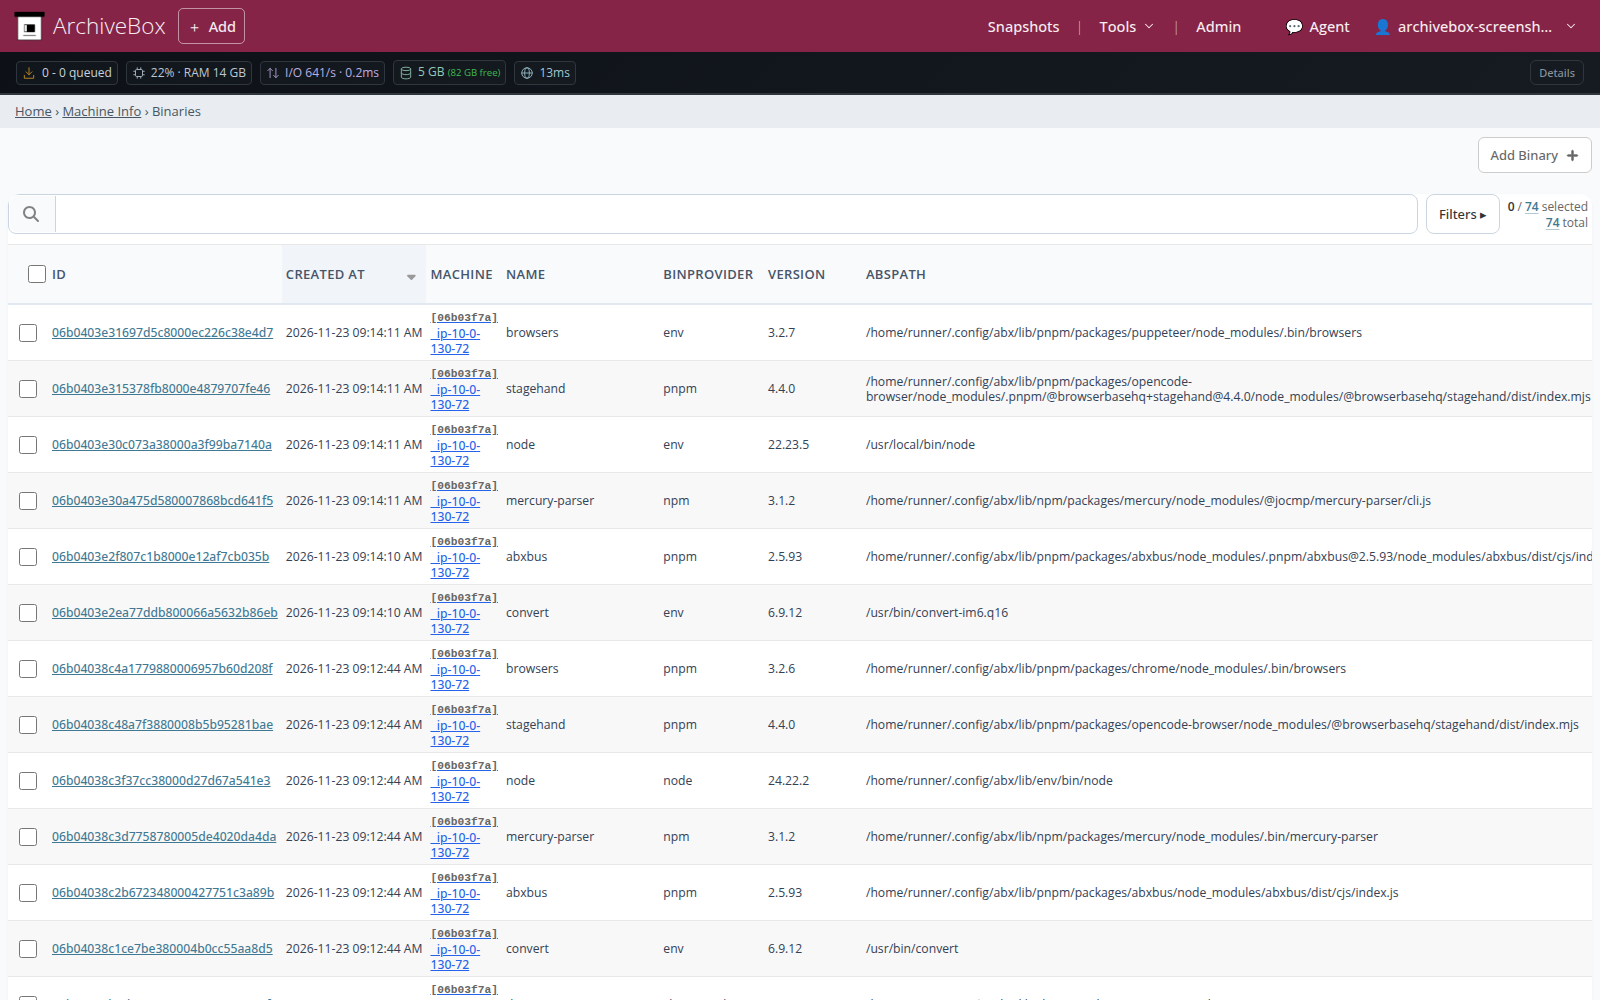
ArchiveBox utilise des outils standard tels que Chrome ou Chromium, wget, curl, yt-dlp, git, SingleFile, Readability et des analyseurs d'articles. Docker regroupe ces dépendances pour des mises à niveau plus faciles et une meilleure isolation ; les installations non-Docker peuvent s'exécuter archivebox install et archivebox --version pour vérifier ce qui est disponible.
Entrées et sorties


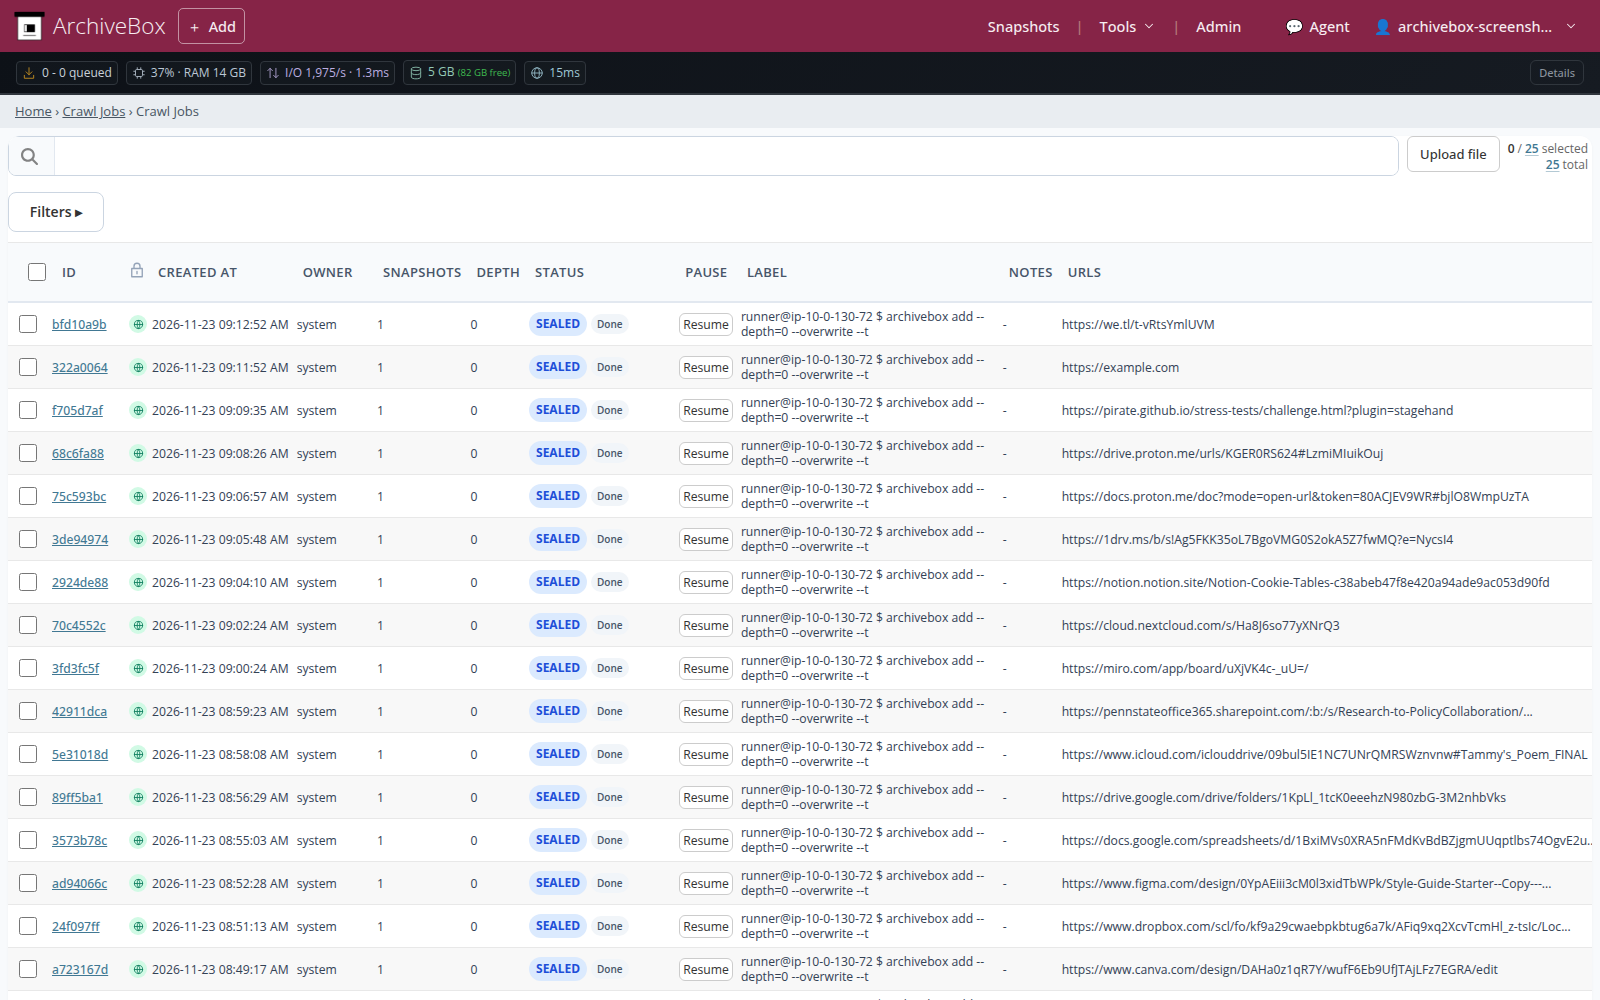
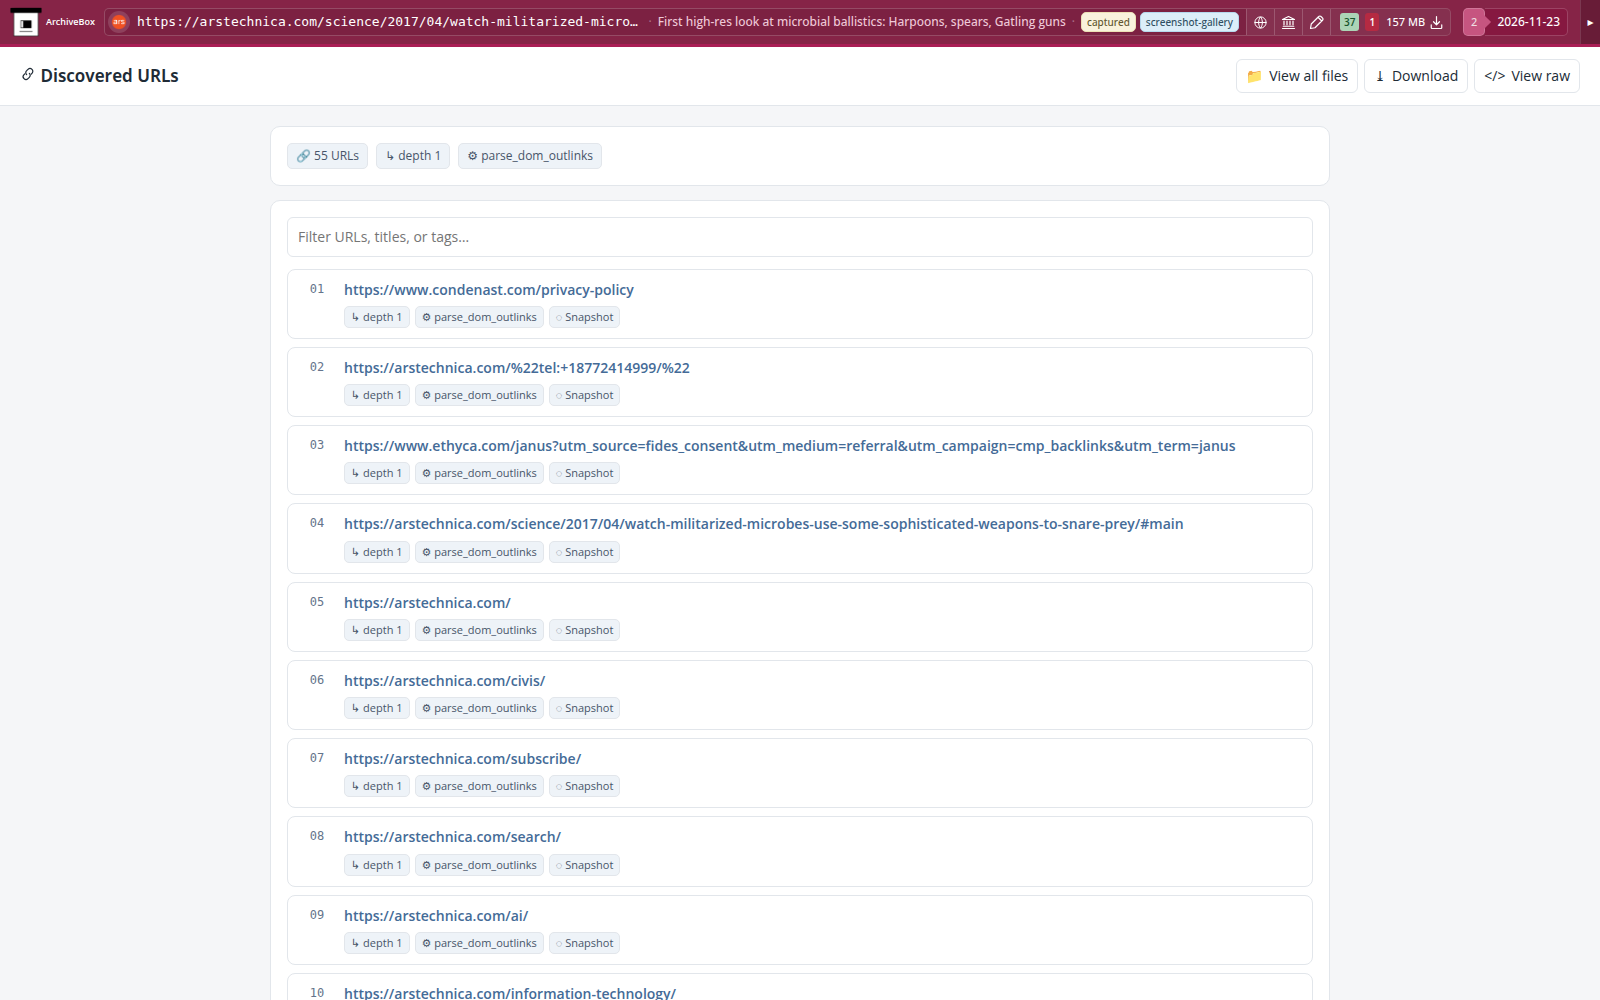
Archive une URL à la fois ou planifier les importations depuis signets, historique du navigateur, RSS, JSON, CSV, TXT, SQL, HTML, Markdown, Pocket, Pinboard, Instapaper, Shaarli, Wallabag, et plus.
Enregistrez les liens avec notre extension de navigateur, ou utiliser Menus de partage Mac et iPhone, Siri et raccourcis.
Importez de nouvelles URL et capturez des instantanés selon un calendrier, puis comparez les instantanés pour voir comment les sites ont changé.
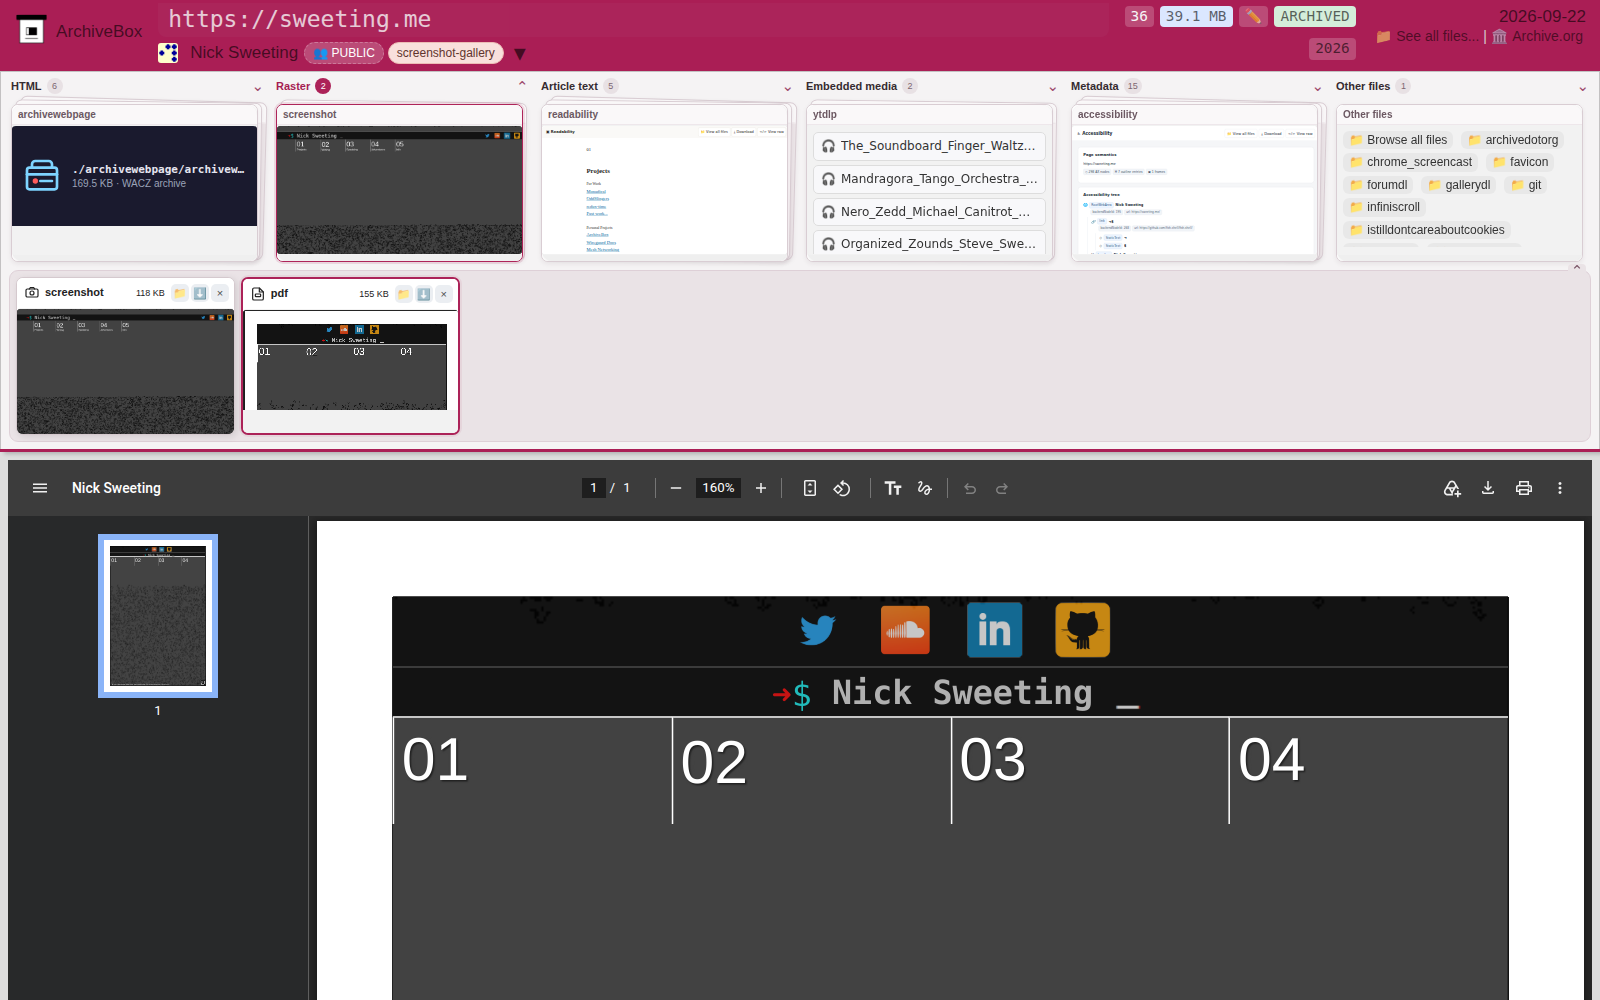
Capturez chaque page dans plusieurs formats réutilisables :
Utilisez la même collection partout où vous travaillez :
Disposition du disque, exportation et sécurité
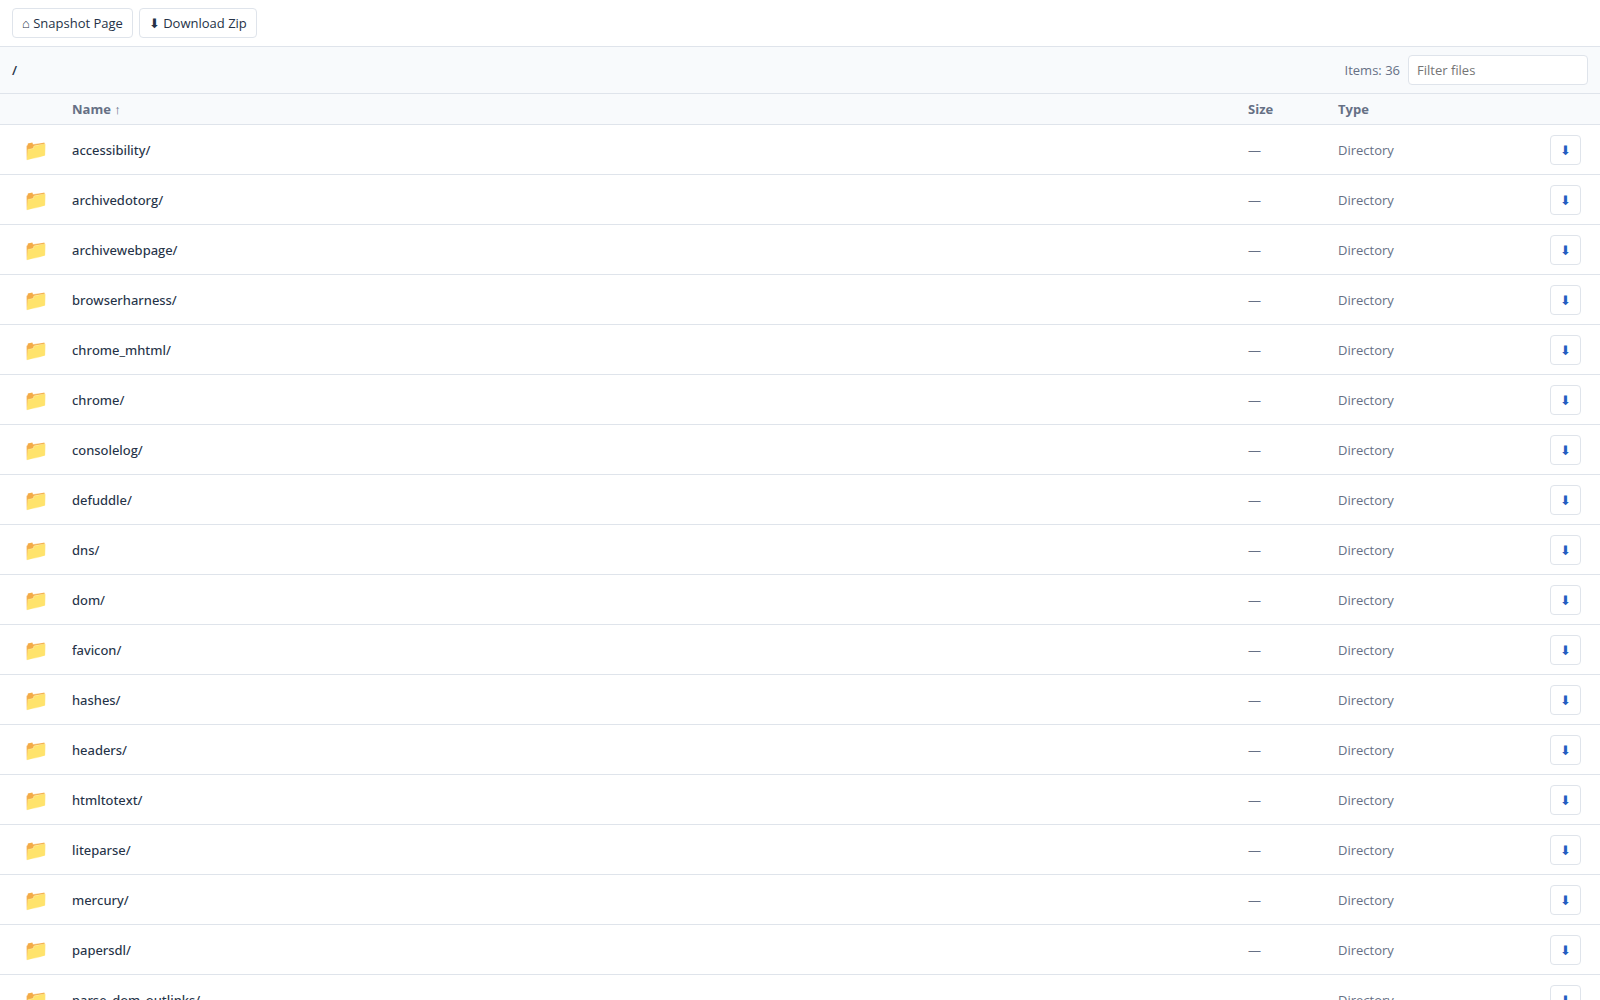
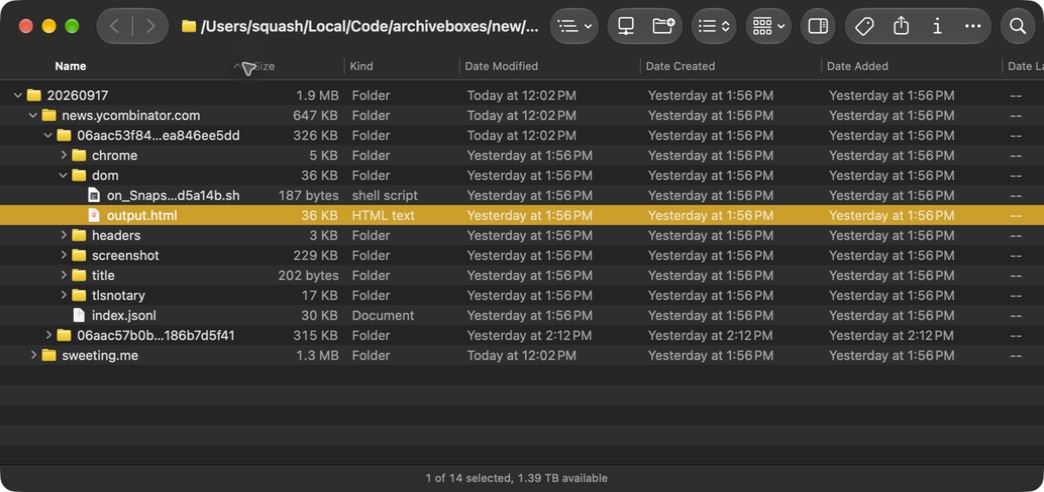
Vos captures sont du HTML ordinaire, des images, des PDF et des fichiers multimédias. Ouvrez-les depuis le Finder, recherchez-les avec n'importe quel outil de recherche de système de fichiers, laissez les agents IA les parcourir directement et sauvegardez-les sous forme de fichiers normaux.
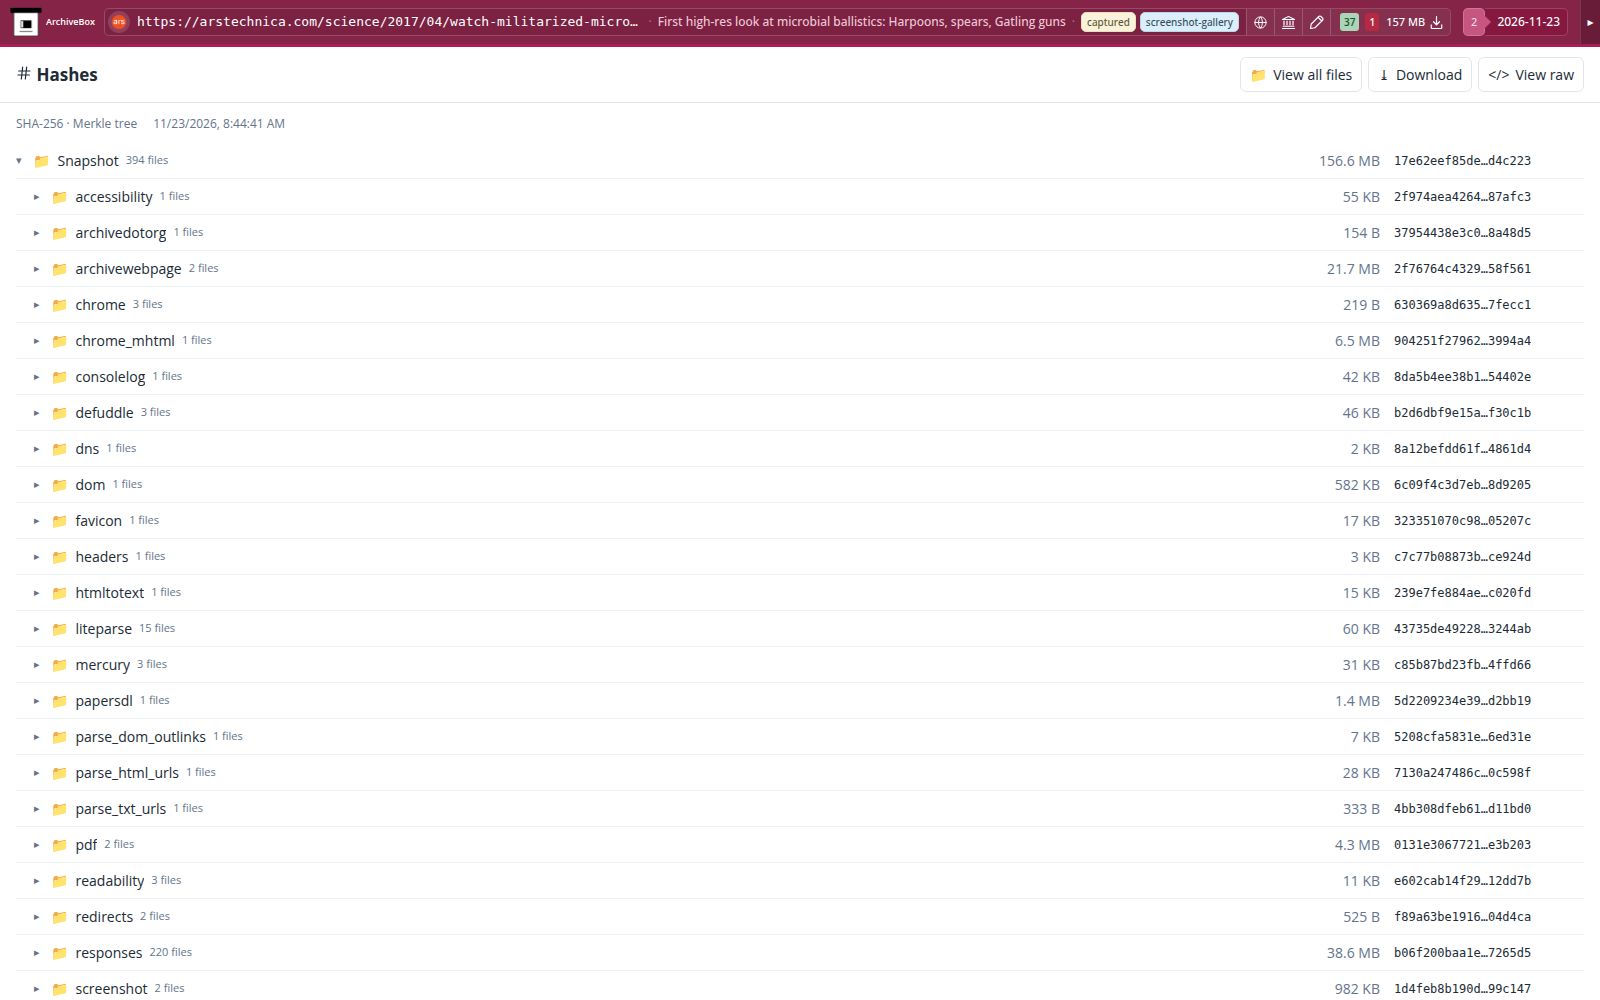
Chaque instantané possède un dossier pour chaque méthode de capture. Le HTML réside dans des dossiers tels que dom/ et singlefile/; les images, les PDF et les médias ont également leurs propres dossiers.
Les métadonnées sont stockées dans SQLite et JSON, avec des métadonnées d'instantané à côté des sorties. La base de données et la configuration de votre collection se trouvent en dehors des dossiers d'instantanés, et vos fichiers restent lisibles sans service hébergé.
Vous pouvez exporter l'index d'archive au format HTML statique, JSON ou CSV avec archivebox list afin que les collections puissent être examinées sans exécuter le serveur Web. Conserver les exportations générées à côté du archive/ afin que les chemins relatifs des instantanés continuent de fonctionner.
$ liste des boîtes d'archives --html --with-headers > index.html
$ liste des boîtes d'archives --json --with-headers > index.json
$ liste des boîtes d'archives --csv=horodatage,url,titre > index.csv
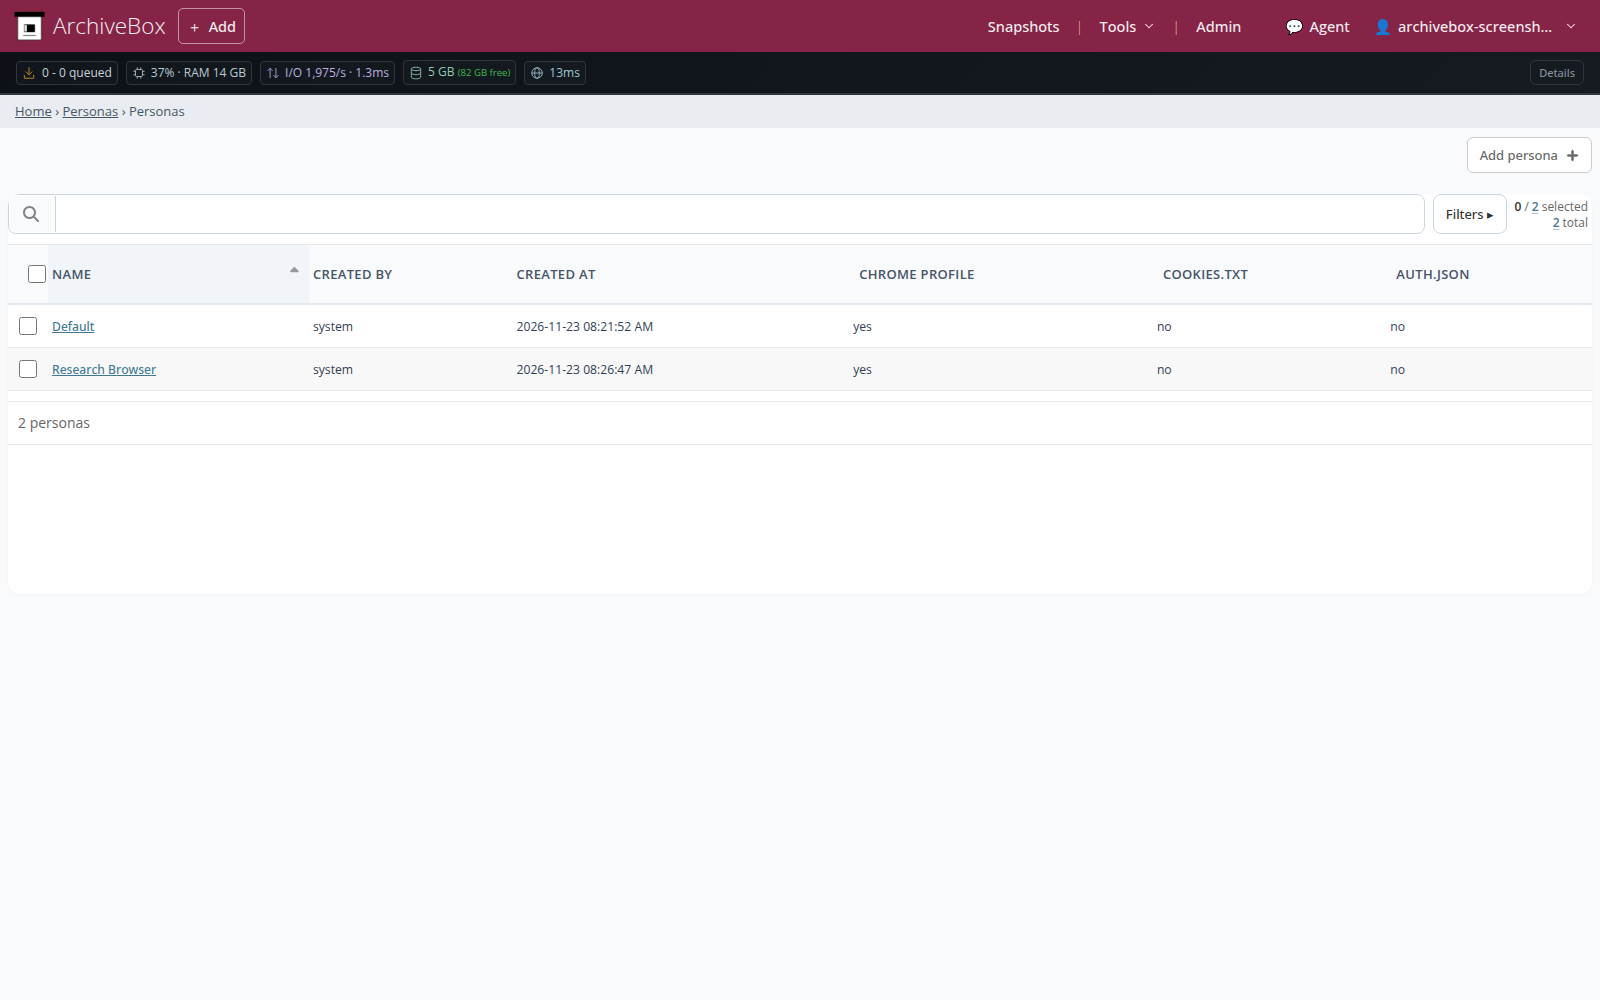
Archivez les URL privées, les pages payantes, les médias non répertoriés et Google Docs à l'aide d'un profil Chrome importé ou un personnage de navigateur dédié. Choisissez quelles captures restent privées et qui peut y accéder.
Restreindre l'accès du public avec PUBLIC_INDEX=False, PERMISSIONS=private, et PUBLIC_ADD_VIEW=False, puis créez des utilisateurs authentifiés avec archivebox manage createsuperuser.
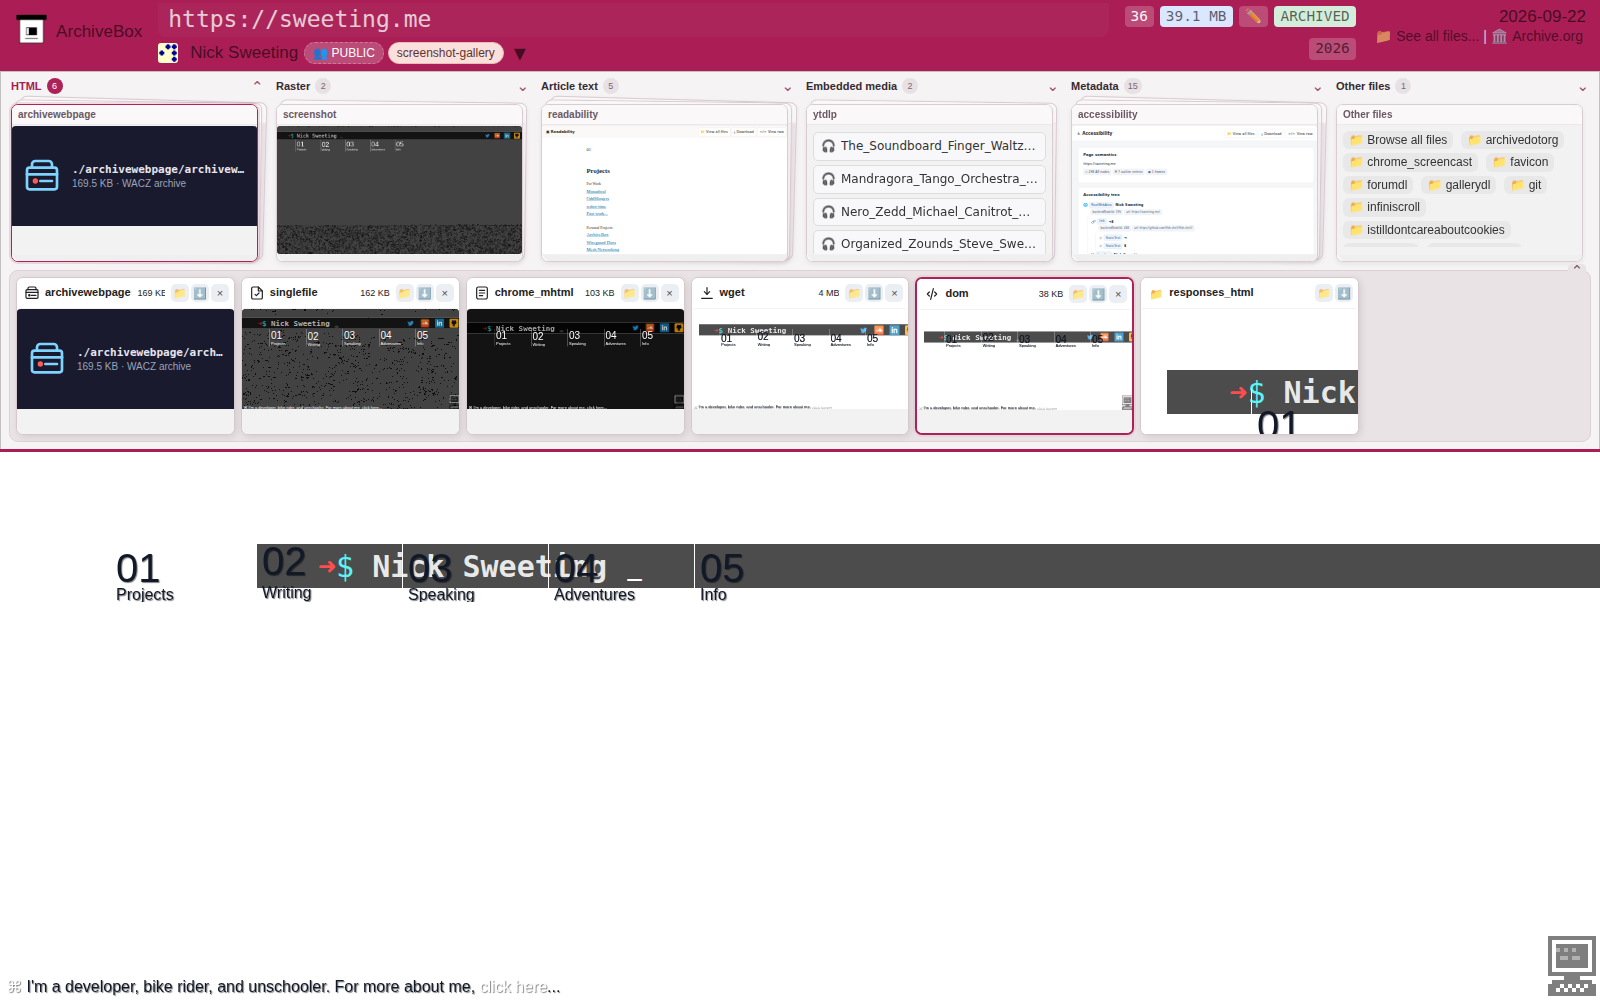
ArchiveBox utilise un Navigateur Chrome pendant l'archivage pour exécuter JavaScript et capturer la page rendue.
ArchiveWeb.page enregistre les pages à relire, y compris leurs scripts et les réponses du réseau. Rejouez les pages capturées avec JavaScript en utilisant ReplayWeb.page, la visionneuse d'archives de Webrecorder.
ArchiveBox peut utiliser environ 1 Go à 50 Go pour 1 000 instantanés en fonction des paramètres multimédia, vidéo, audio et de l'extracteur. Régler YTDLP_ENABLED et YTDLP_MAX_SIZE pour les collections à forte intensité médiatique.
Garder index.sqlite3 sur le stockage local ou SSD lorsque cela est possible. Grand archive/ les dossiers peuvent vivre NFS, SMB, FUSE, Soutenu par S3, ou Stockage sur disque dur, mais les configurations Docker et de partage de fichiers peuvent avoir besoin ajustements de propriété et de courge-racine. Évitez les systèmes de fichiers plus anciens comme EXT3 ou FAT pour les très grandes archives.
Contexte et motivation
ArchiveBox existe parce que la pourriture des liens, le désabonnement des plateformes, la censure et la disparition des médias effacent régulièrement les connaissances utiles. Le projet vise à rendre le contenu Web qui vous intéresse visible avec des logiciels courants dans 50 à 100 ans, sans nécessiter ArchiveBox ou un service de relecture hébergé pour comprendre vos fichiers.
Les archives publiques centralisées sont essentielles, mais toutes les pages n’ont pas leur place dans un service public mondial. ArchiveBox permet aux individus et aux organisations de sauvegarder le matériel public ou privé auquel ils peuvent accéder, de le conserver localement ou au sein de leur institution et de décider quoi publier au cas par cas.
Exécutez-le en tant qu'application Web Docker, utilisez des commandes CLI uniques ou automatisez avec des API tout en gardant les données privées et publiques soigneusement séparées. Utilisez des fichiers ordinaires pour les sauvegardes et les exportations.
L'archivage responsable dépend de votre juridiction, de votre cas d'utilisation et de votre politique de publication. ArchiveBox est un outil ; les opérateurs restent responsables du traitement des données privées, des droits d’auteur, des demandes DMCA ou GDPR et des exigences légales locales.
Les instances publiques doivent publier les informations de contact et de suppression, éviter de monétiser le contenu copié et examiner la documentation de sécurité et de publication avant d'exposer les instantanés à des spectateurs anonymes.
Vous recherchez une gestion spécialisée de l'exploration, de la relecture ou des favoris ? Explorez ces autres projets d’archivage Web.